Salesforce 披露 Agentforce 分层技术栈:70 亿 AWU,单一大 Prompt 超 8 条失效
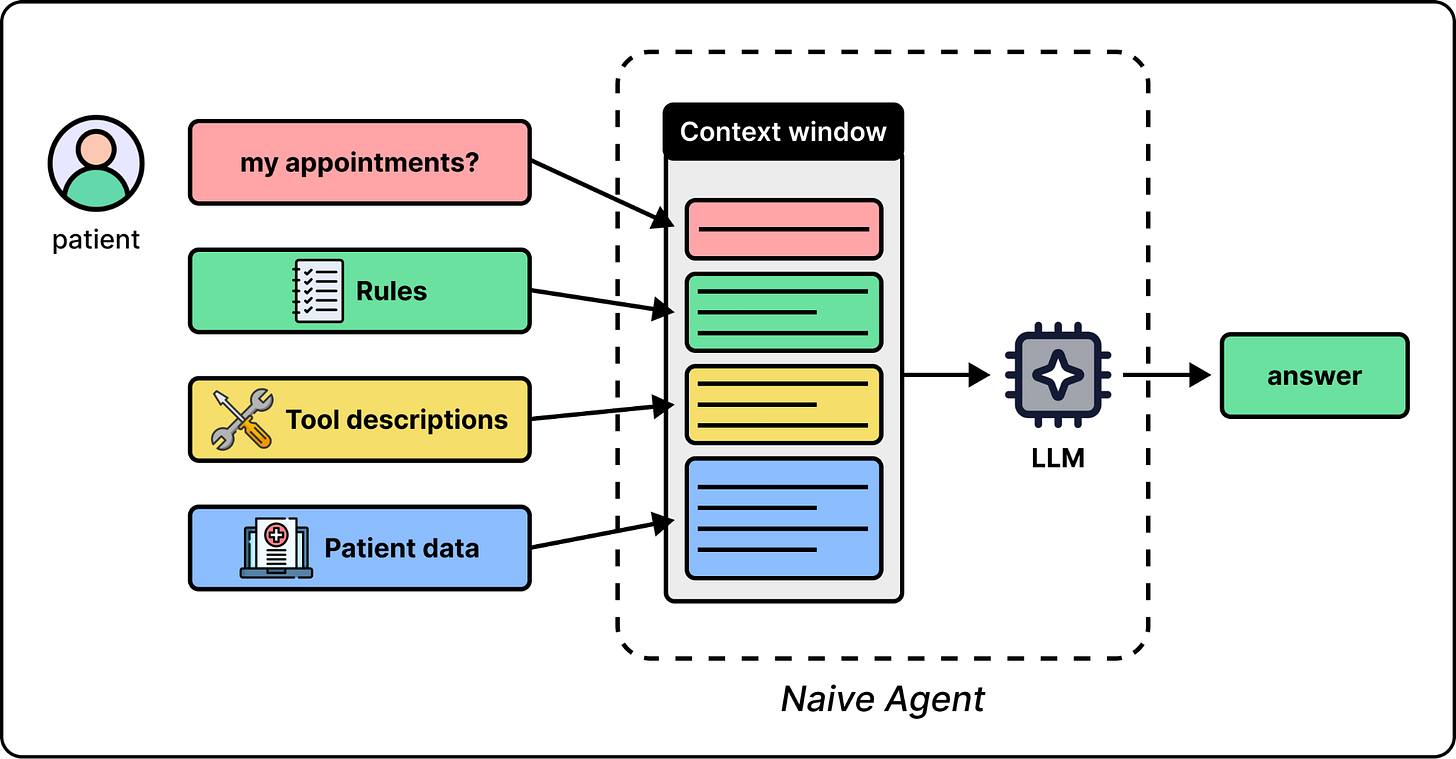
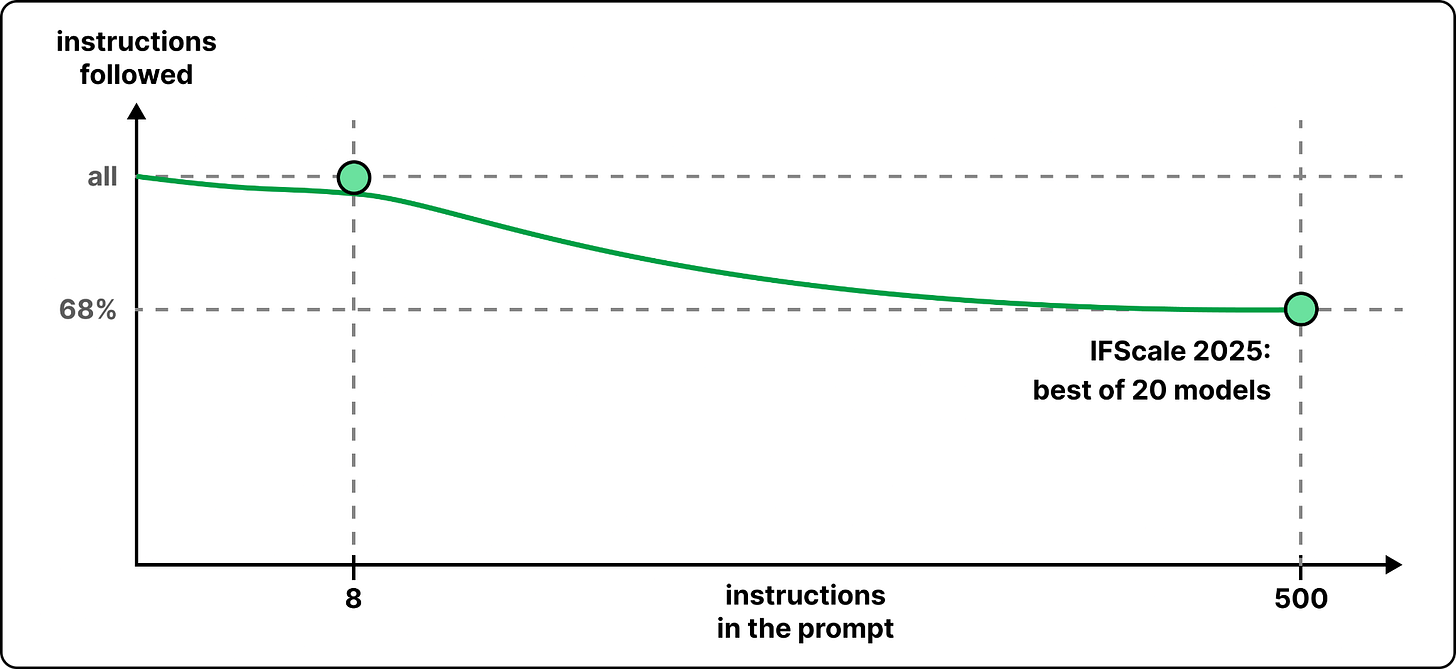
- 规模与原始设计:Salesforce 称 Agentforce 与 Slack 累计完成 70 亿 Agentic Work Units(AWU),其中第二季度完成 32 亿。第一版 Agentforce 将所有规则、工具说明与业务数据放入一个 prompt,团队观察到指令超过 8 条后模型开始丢弃;文中引用 IFScale 基准,20 个模型在最多 500 条简单指令下,最佳模型全量仅遵循 68%。
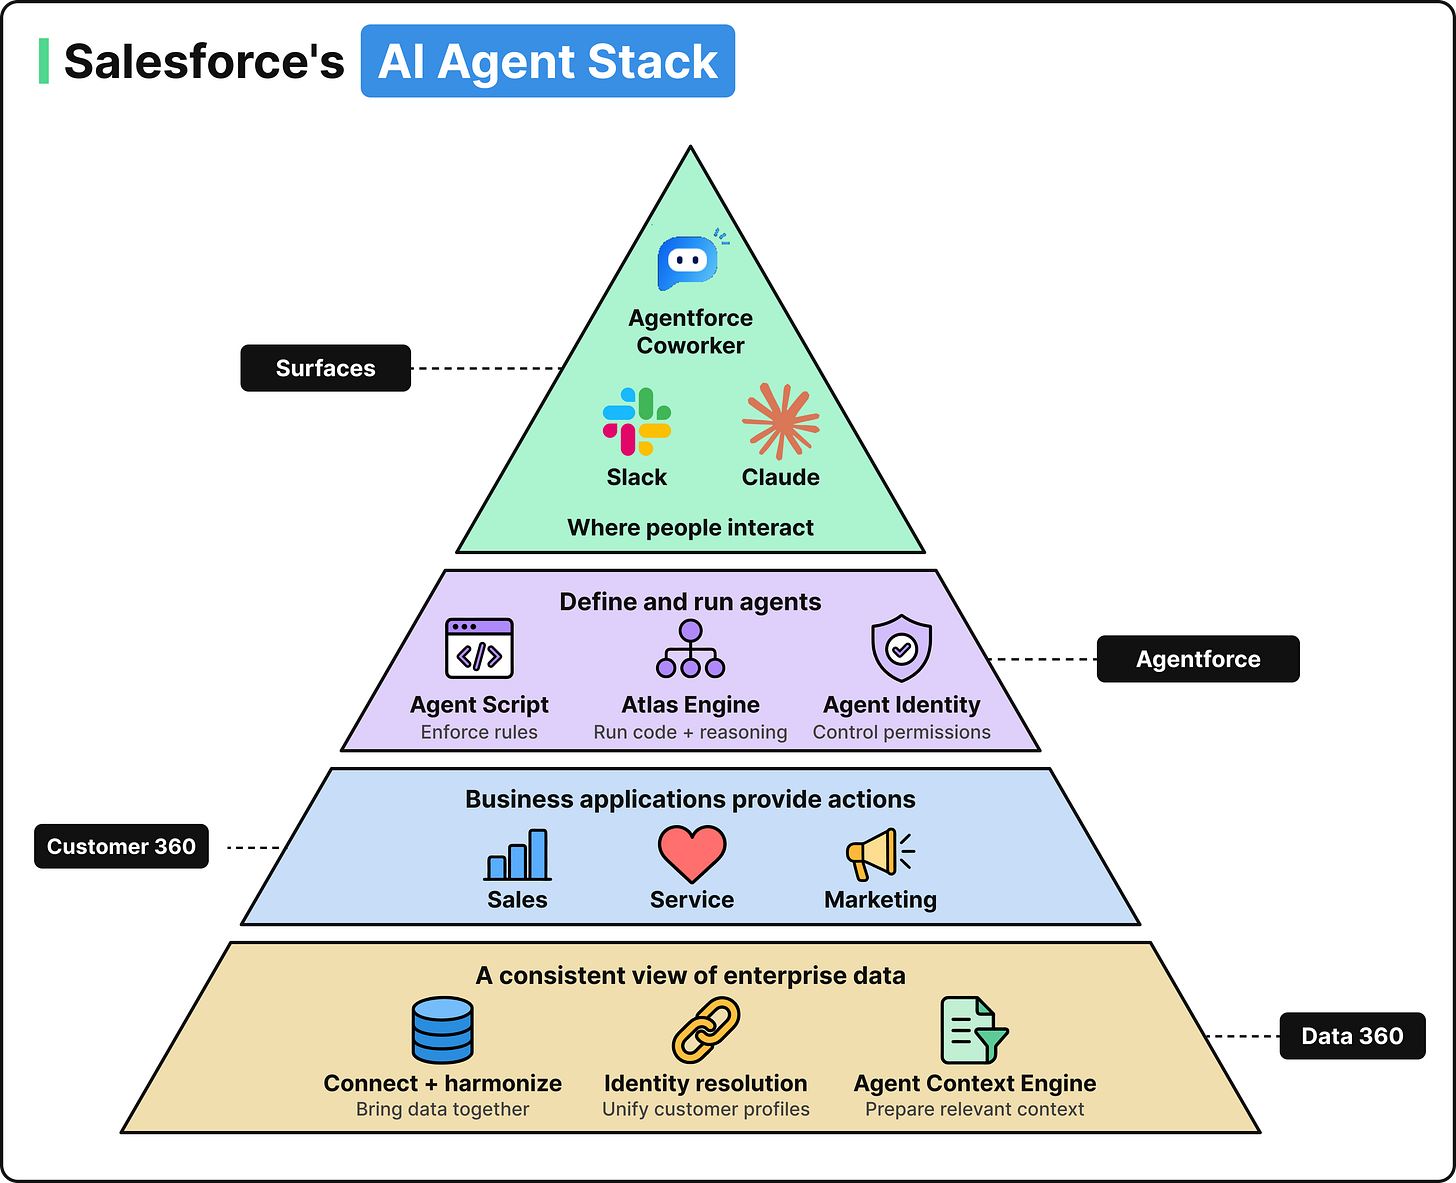
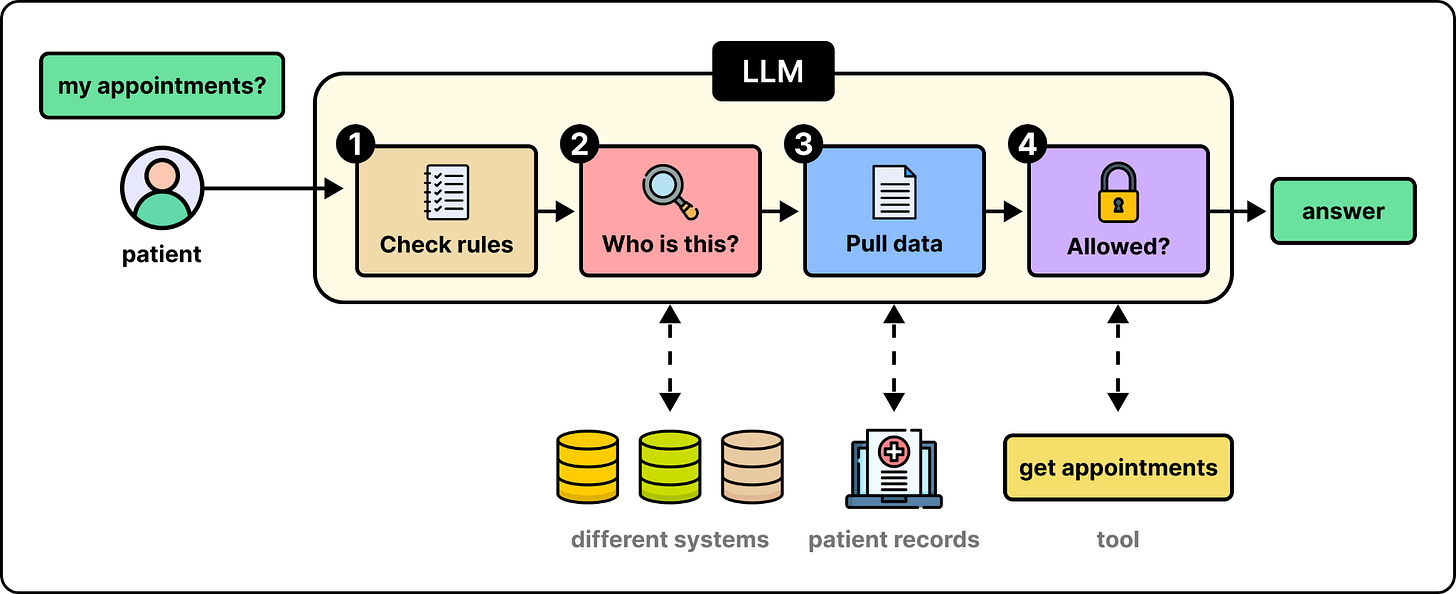
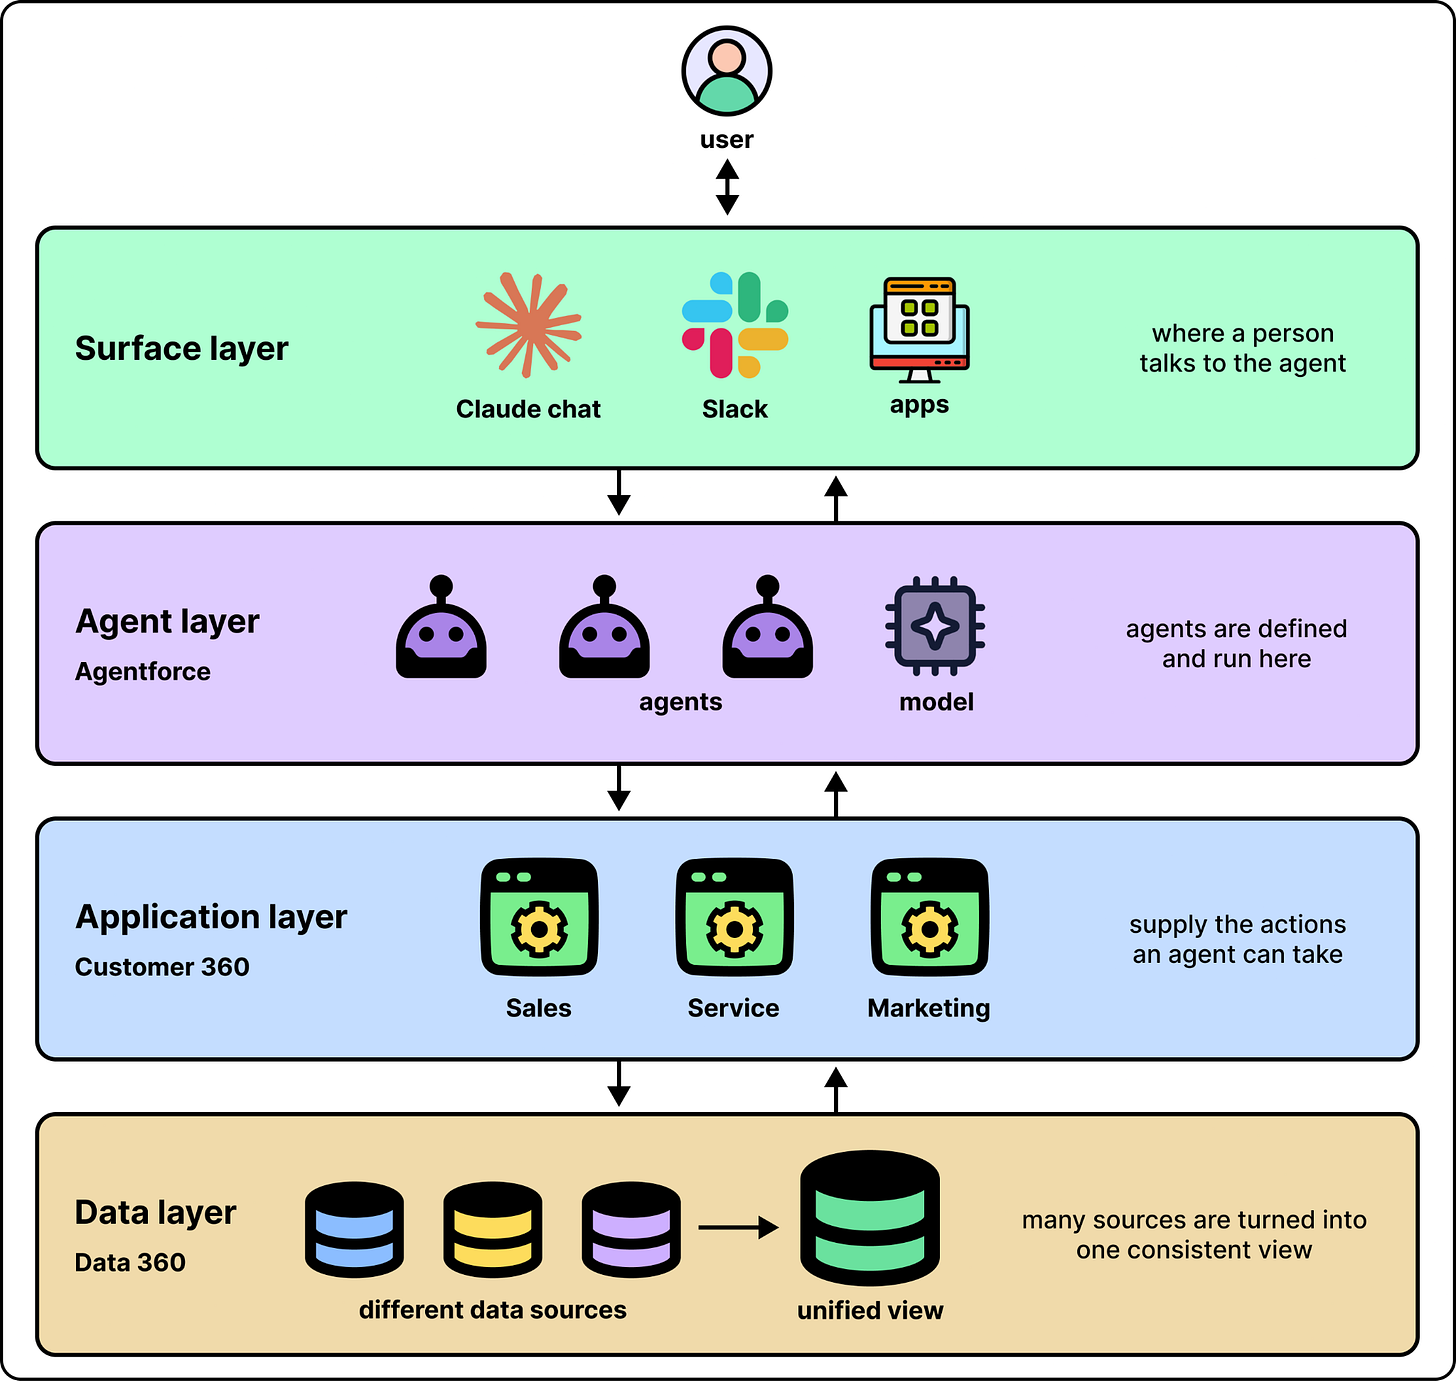
- 分层架构:新设计把规则、身份、数据与权限从 prompt 中拆出,分为 Data 360、Customer 360、Agentforce 与 Surface 四层。Agentforce 内的 Agent Script 用确定性代码描述行为,编译为 Agent Graph 后由 Atlas Reasoning Engine 执行,只在需要推理时调用模型;Data 360 负责跨源数据映射与身份解析;Agent Context Engine 负责为每次请求选择上下文;Agent Identity 为 Agent 分配独立权限,并在操作前同时校验用户权限、Agent 权限与数据策略。
- 上下文与成本数据:文中示例显示,保险计划查询在无上下文管理时消耗 124,000 tokens,引入 Agent Context Engine 后为 9,000;后续迁移与投保场景中,无上下文管理约消耗 300,000 tokens,使用上下文引擎后约 65,000(含处理投保的第三步)。
- 外部接入与后续方向:AIforce 与 Headless Toolkit 把 Salesforce 数据和动作暴露给 Slack、Claude 等表面;Salesforce API 每日调用量 96 亿次,Skills 发布在 sf-skills GitHub。MCP Server 用 4 个工具定义,通过 discover、describe、dispatch 三步让 Agent 先检索工具、读取契约再执行,避免把所有工具定义装入上下文。Salesforce 称下一步是把这些组件整合为 Enterprise AI Harness。
- 工程含义:这条拆解把生产 Agent 的可靠性落到确定性编排、上下文选择、独立身份与工具索引四类组件,而不是仅依赖模型对长 prompt 的指令遵循。 🔗 ByteByteGo Newsletter