Octave 在 Bedrock 上构建多租户隔离 AI 检索底座
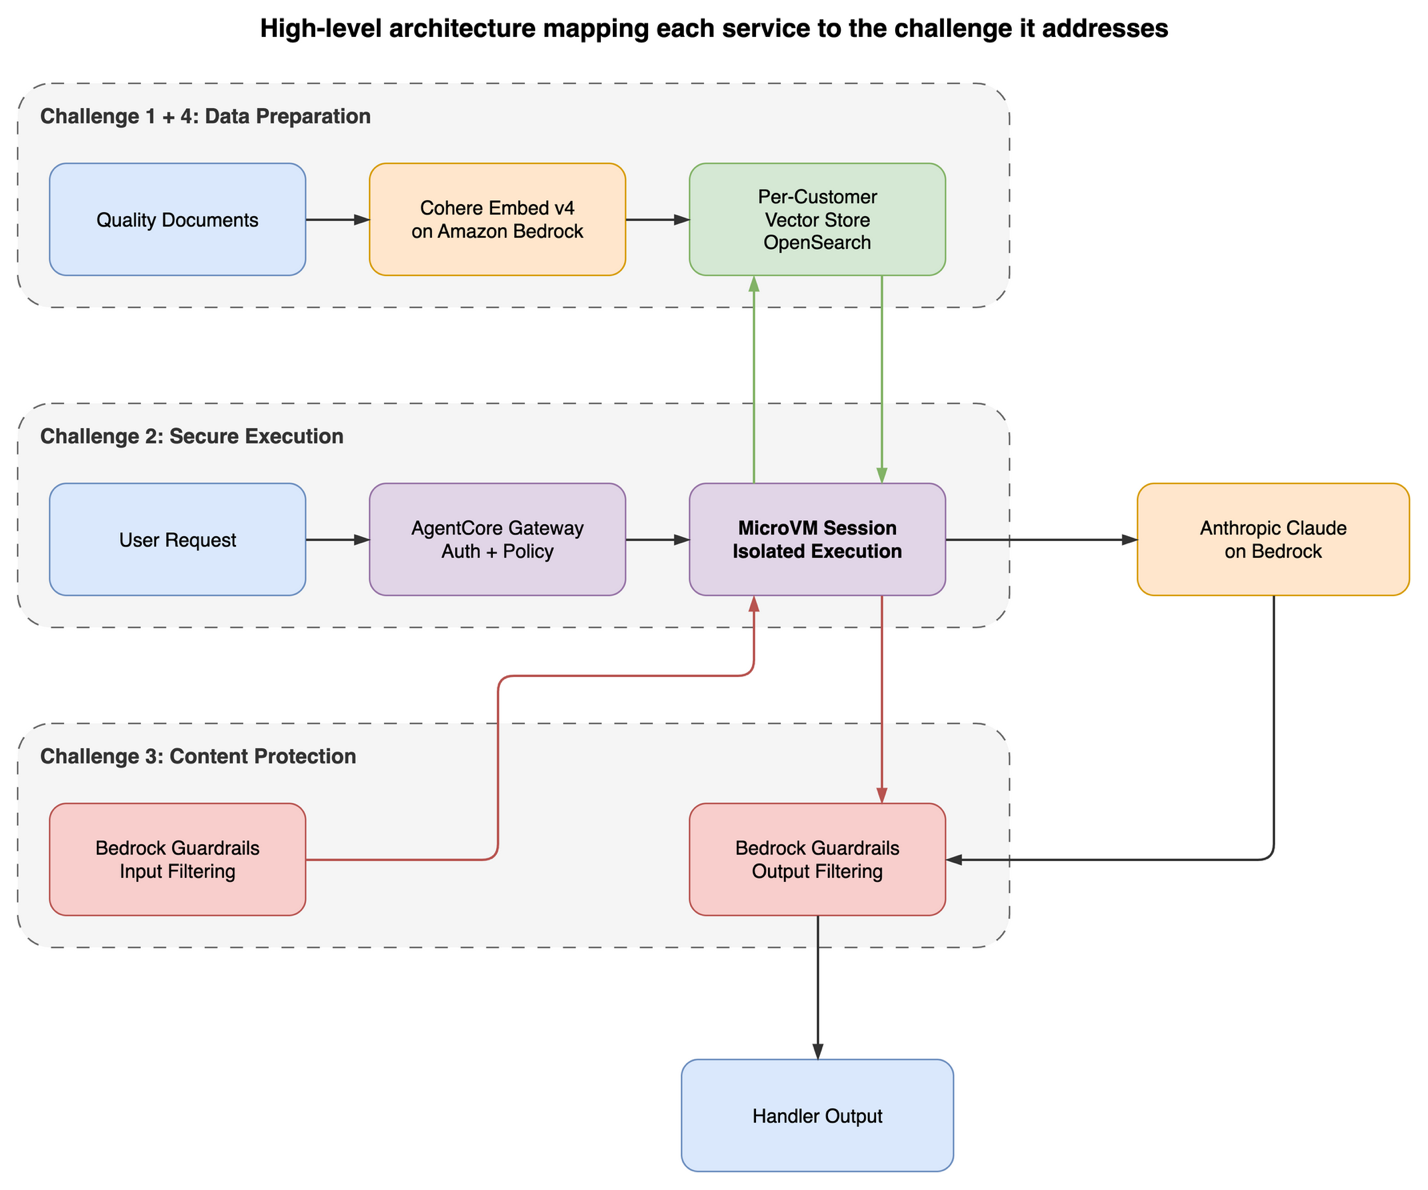
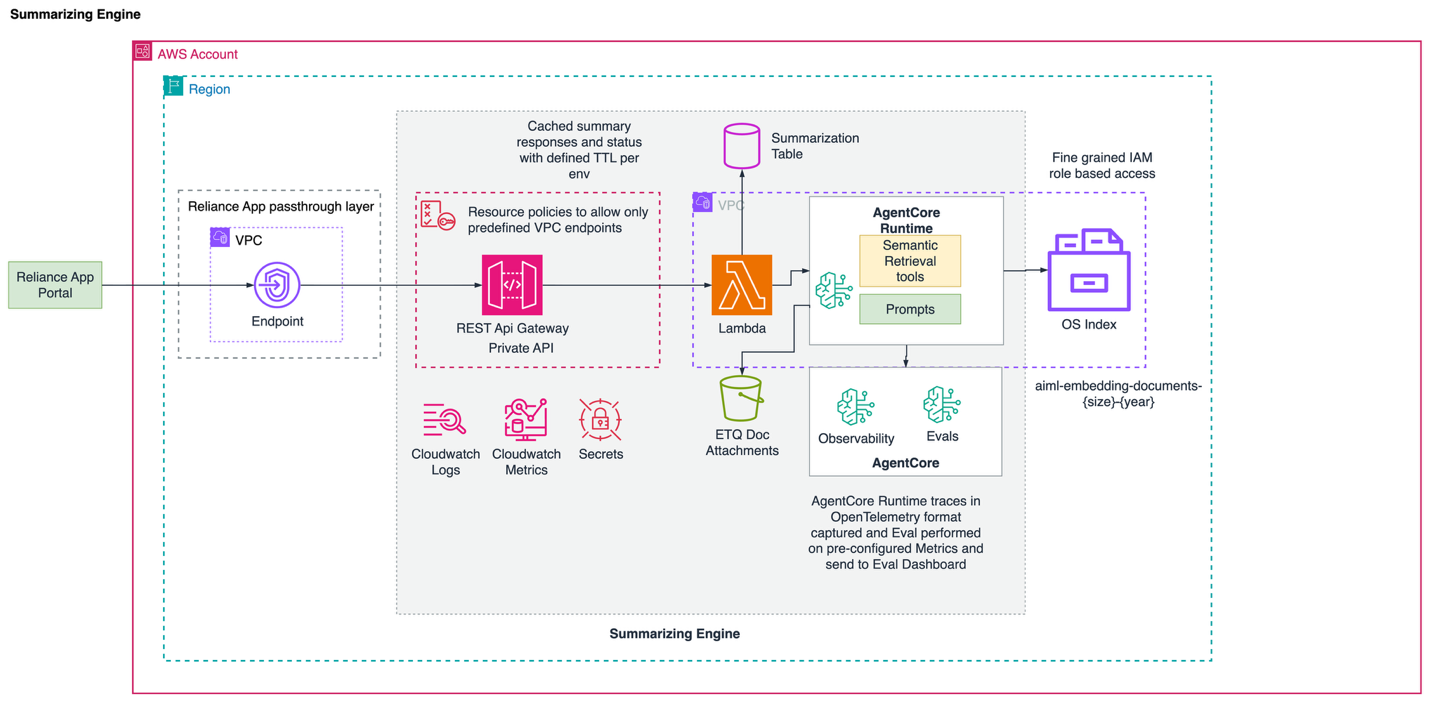
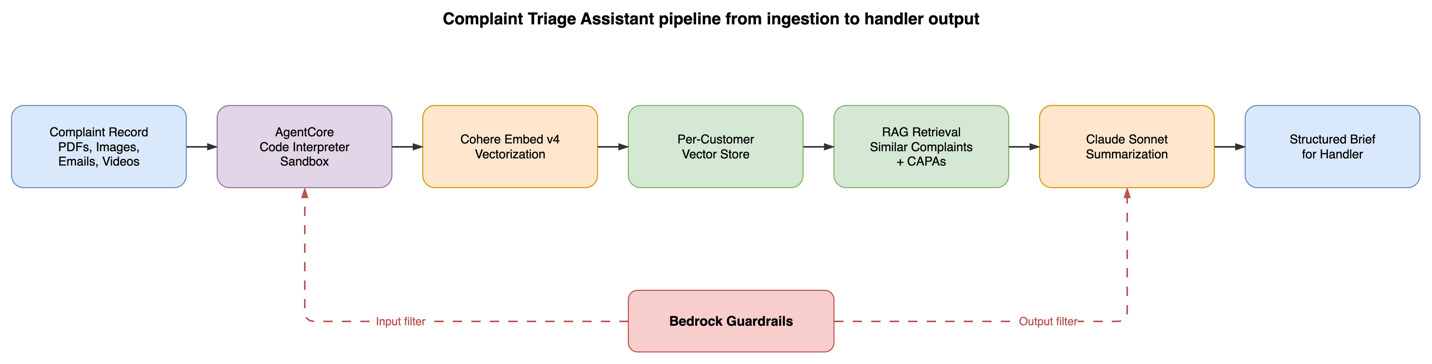
- 核心架构:Octave Reliance 先建三层底座再切功能——Cohere Embed v4 on Amazon Bedrock 把质量文档嵌入按租户划分的 OpenSearch 向量库;AgentCore Gateway 执行认证与策略,AgentCore runtime 为每个用户会话启动独立 microVM;Bedrock Guardrails 在输入、检索/工具输出与生成结果三处过滤。
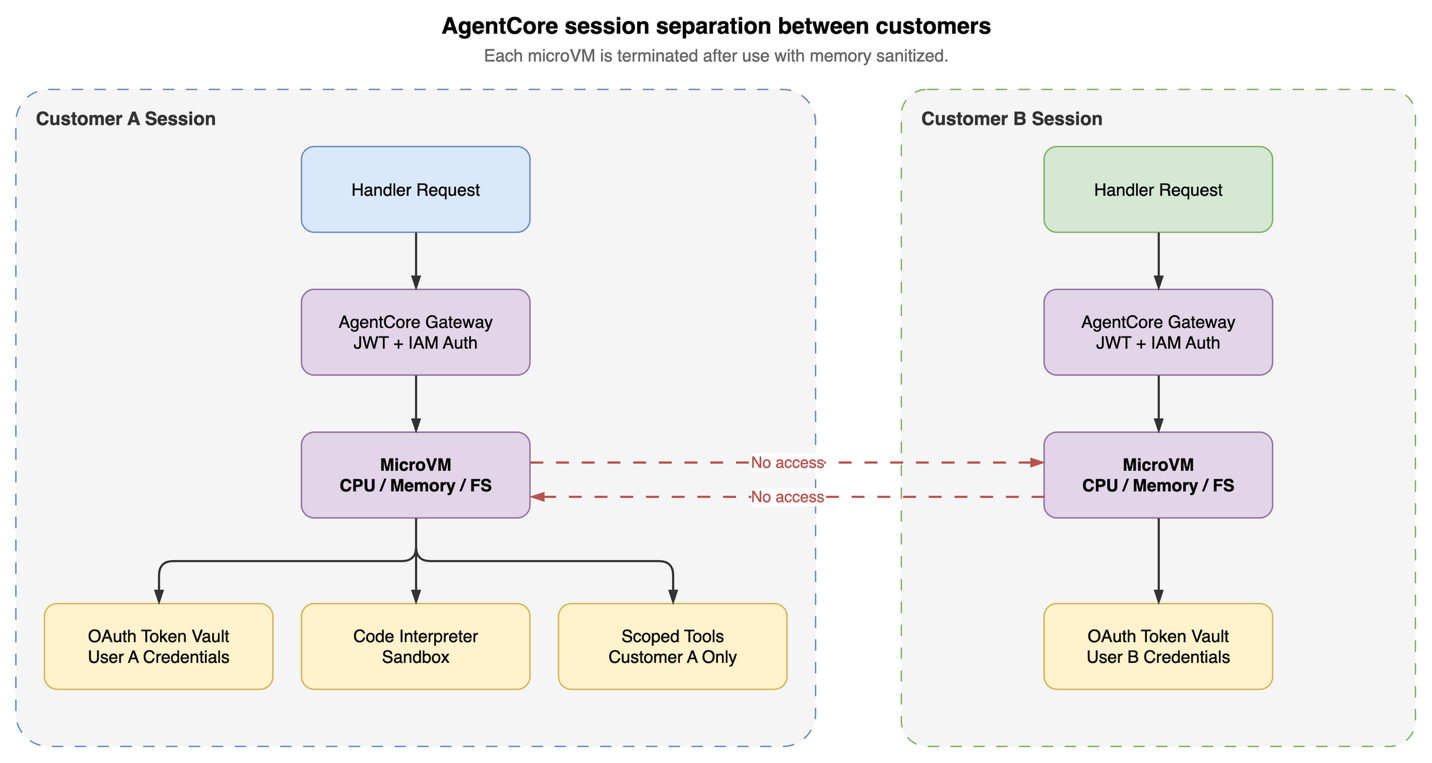
- 隔离与合规:租户隔离被下沉到运行时而非应用代码。每个会话有独立 CPU、内存与文件系统,结束后停止并清理内存;用户身份通过 per-user OAuth token vault 贯穿执行链,凭证按 agent 作用域且仅在会话期间存在。检索、执行、内容保护分属不同阶段,可分别强制执行与留证。
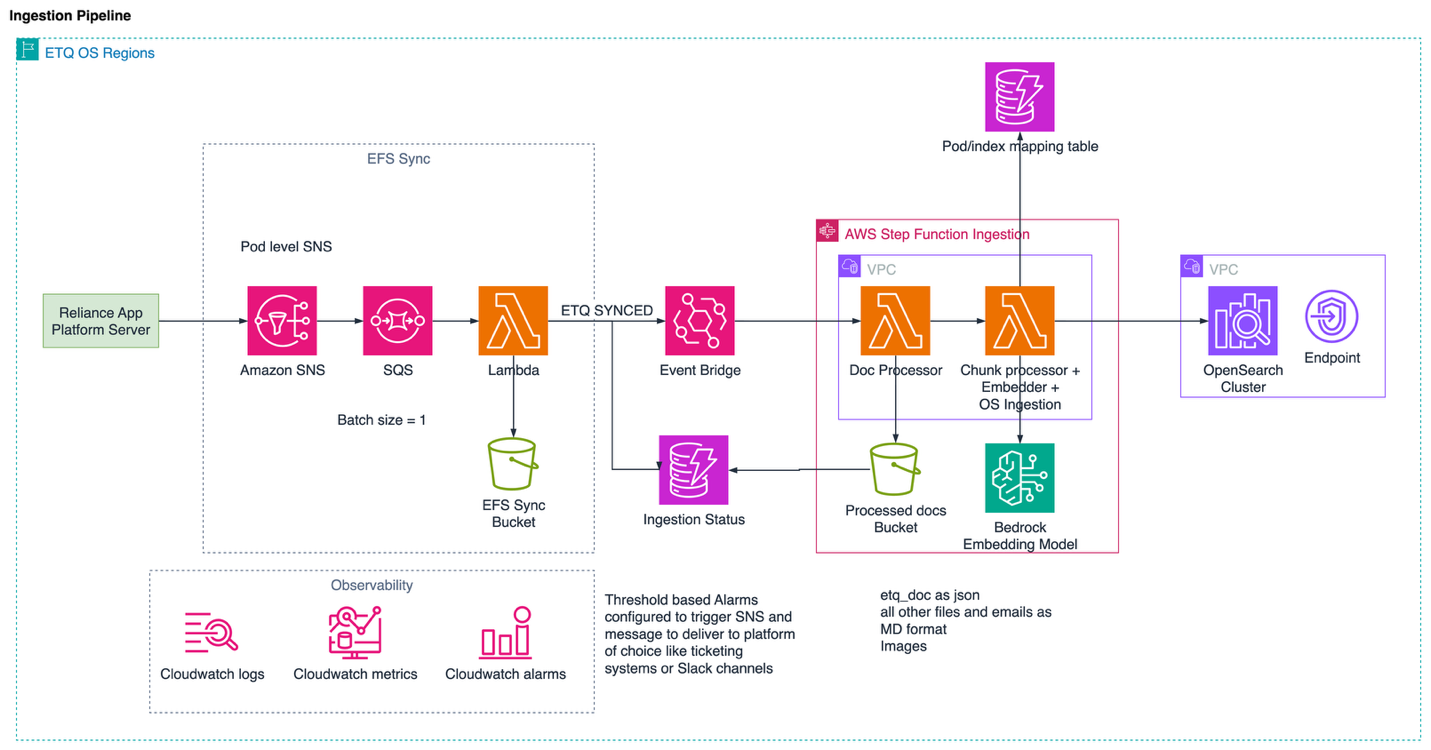
- 吞吐与成本:团队把约 4K token 的块打包进 Embed v4 的 128K 上下文,减少 API 调用;内部测试达到 2800 万 token/分钟,单租户工作负载 24 小时处理 140 万份文档。向量维度从默认 1536 降到 512,在代表性生产查询上保持目标准确率,同时存储成本降低约 66%。
- 生产结果:投诉分诊助手运行三个月,把每起调查中跨格式抽取、查找历史先例与阅读的 4–6 小时工作交给流水线;新 AI 能力的部署周期缩短 50%,语义搜索比原计划提前两个季度上线。
- 行业意义:对需要让 Agent 读取受监管客户数据、又不能跨租户泄露的 SaaS 平台,这个案例把隔离边界放在 microVM、身份传播与分阶段内容过滤上,而不是依赖应用层逐路径检查;代价是基础设施先行,收益是后续功能复用同一套数据准备、执行与检索层。
- 信息边界:上述吞吐、成本与生产数据来自 AWS 博客与 Octave 自述,未见第三方复现。