ByteByteGo 对比 LLM 提示缓存与语义缓存:共用前缀与相似答案,成本与正确率取舍不同
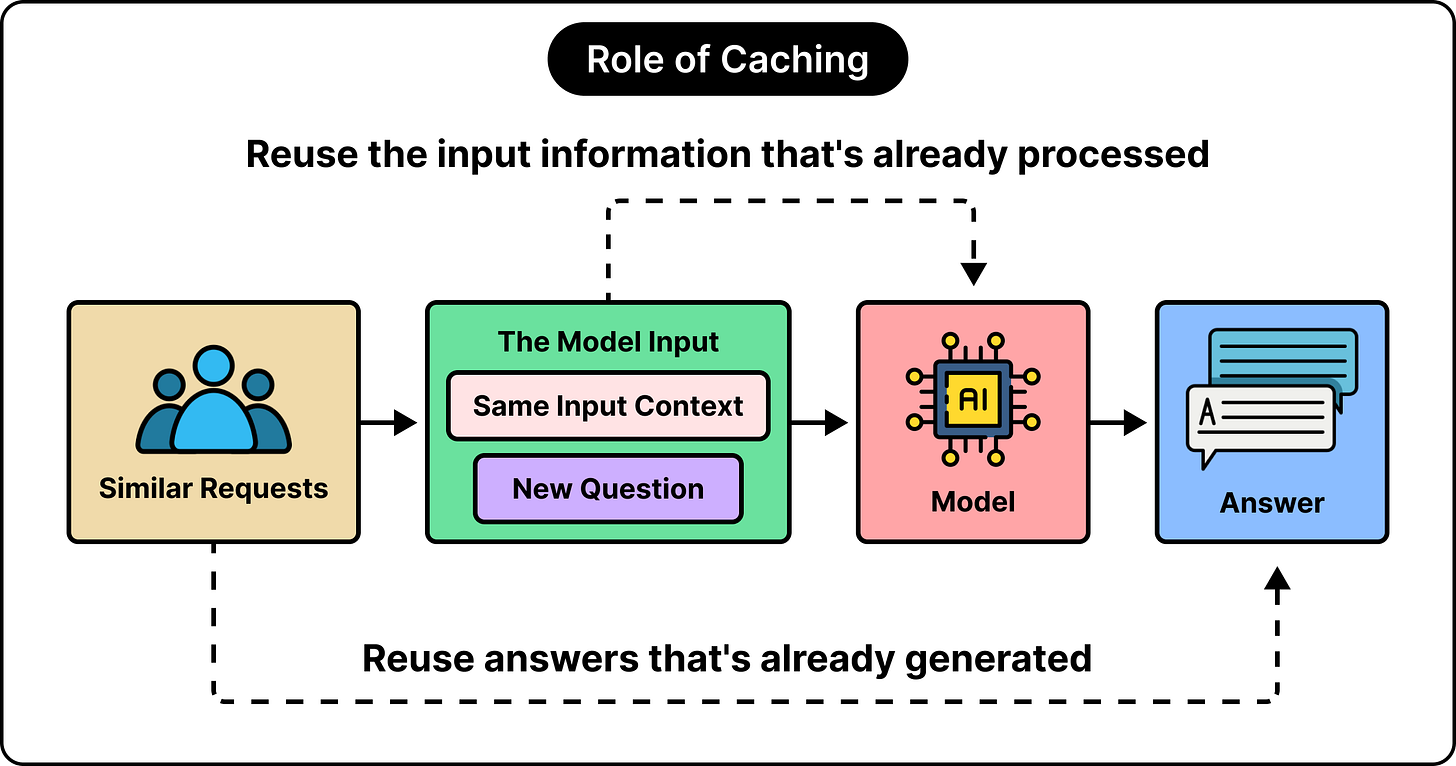
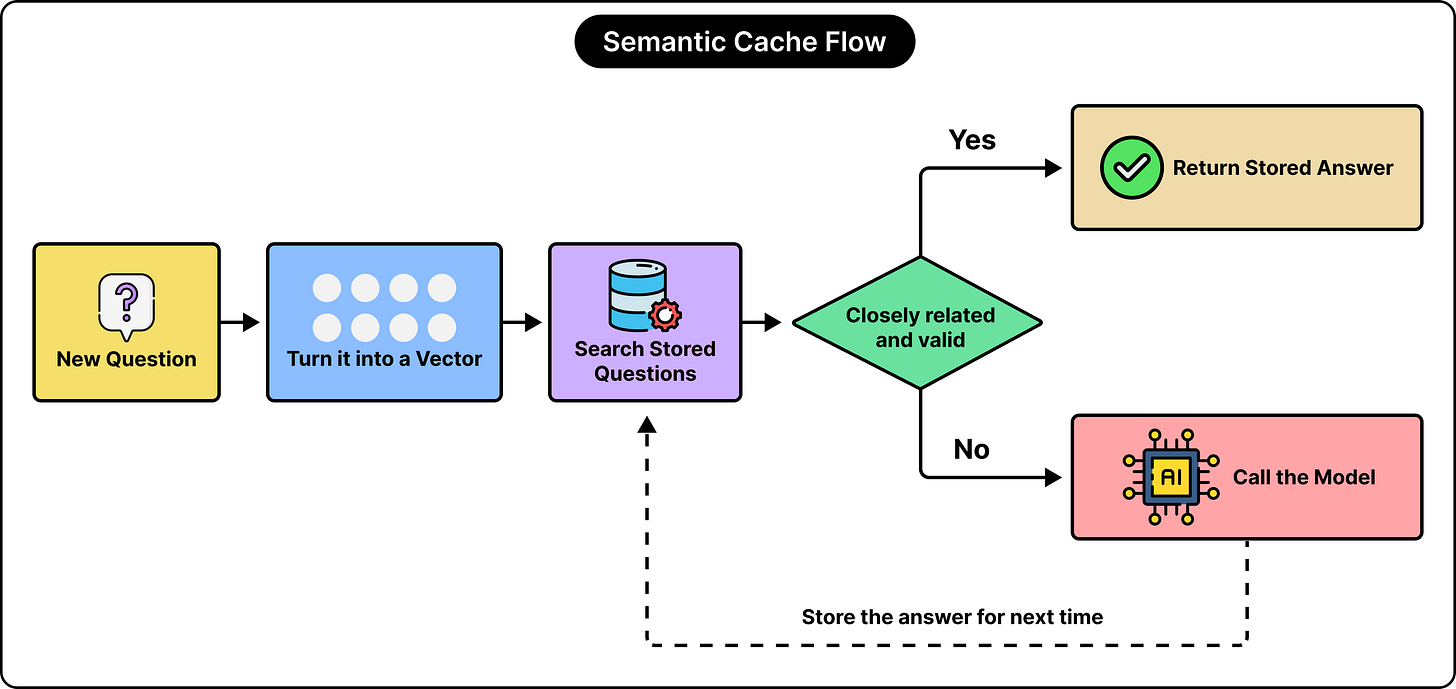
- 两条路径:提示缓存复用共享输入前缀的 KV 状态,命中后仍需生成答案;语义缓存位于应用层,用嵌入模型比对历史问题,命中即直接返回旧答案,两者作用在请求的不同阶段。
- 定价口径:文章以 Anthropic 为例,缓存读取约常规输入价的 1/10,5 分钟写入为 1.25 倍、1 小时写入为 2 倍;一次写入加一次读取总成本约为常规的 1.35 倍,读取次数越多摊薄越明显,前缀若从未复用则无收益。
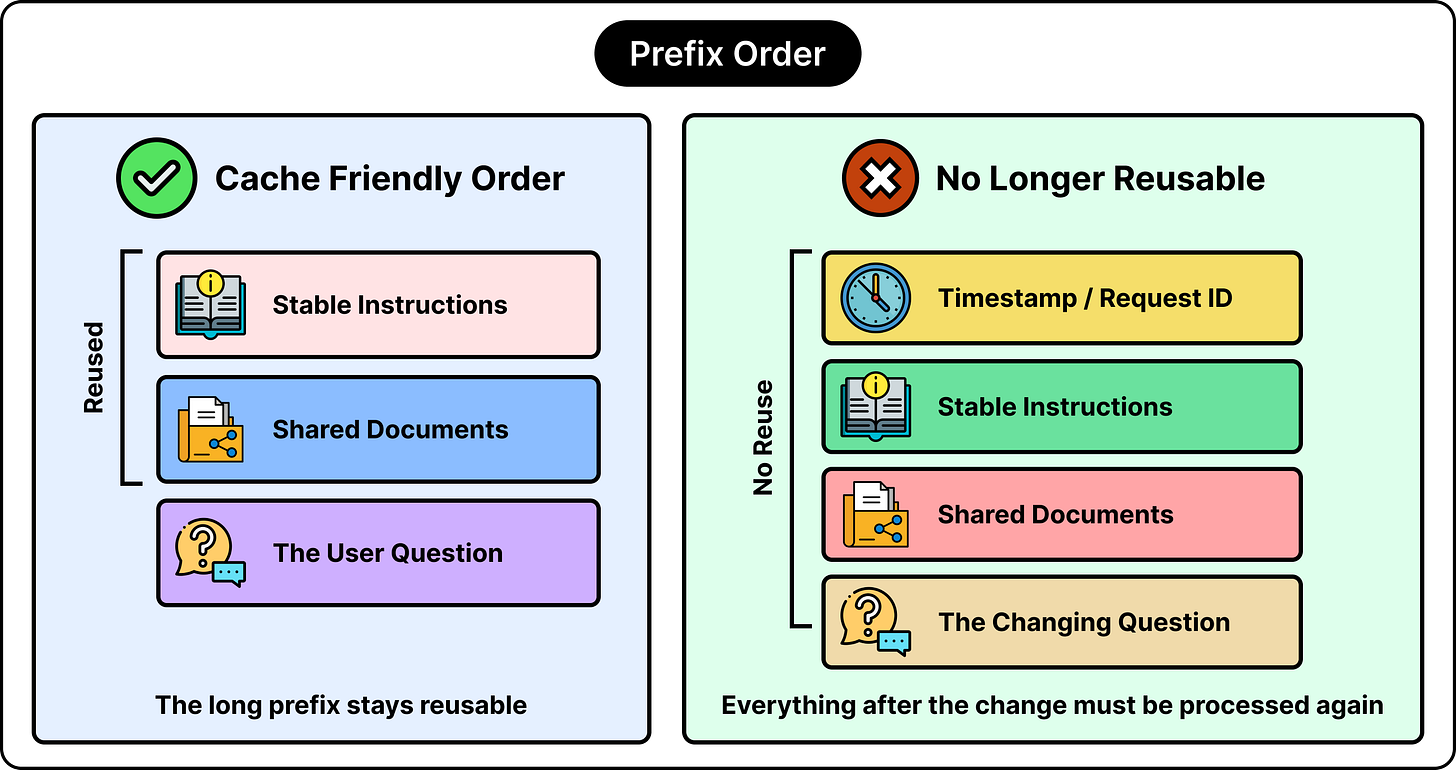
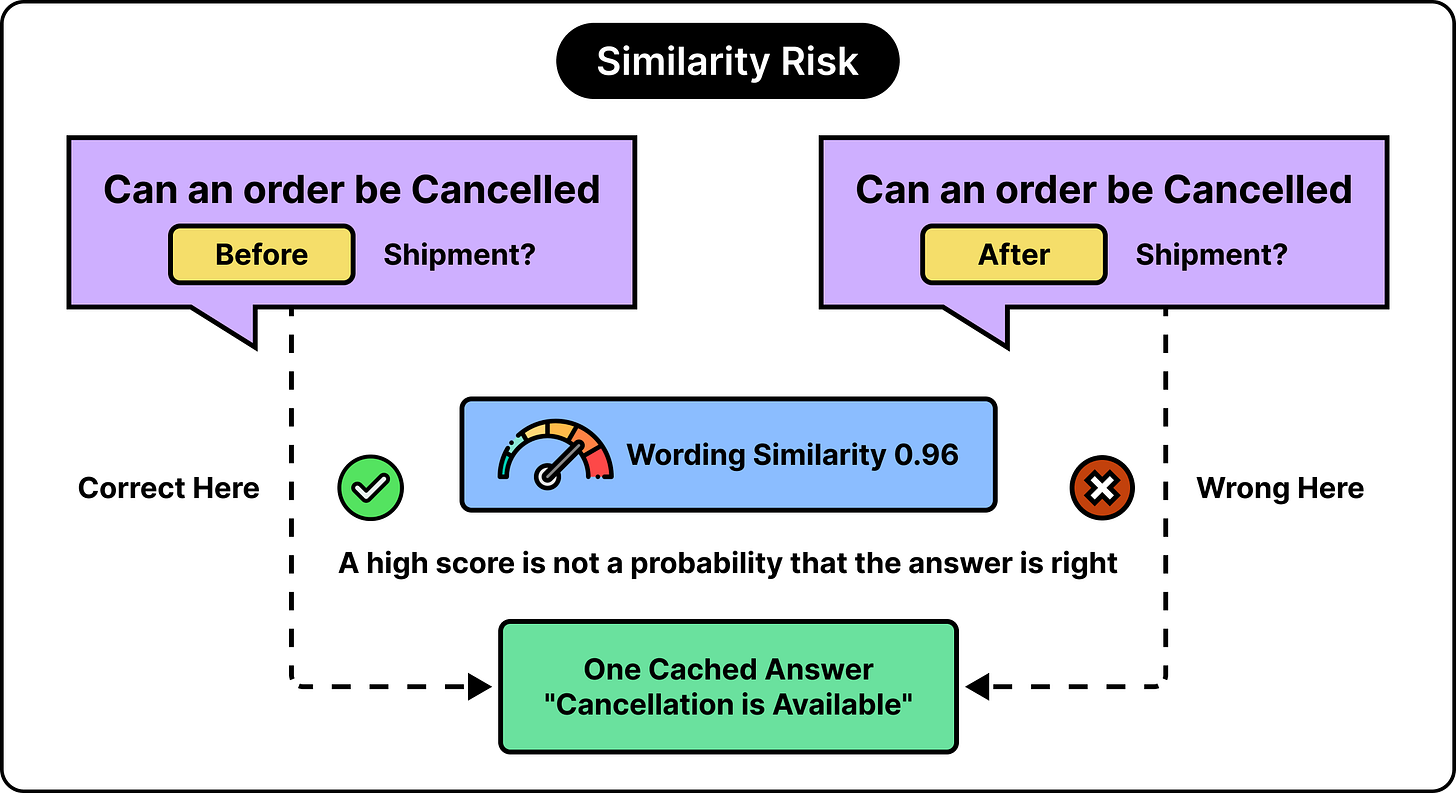
- 边界条件:提示缓存要求共享内容位于请求开头且逐字不变,时间戳或随机 ID 前置会让整段前缀失效;语义缓存需按业务逐项校准相似度阈值,避免把“发货前取消”与“发货后取消”这类近邻问题混淆。
- 失效策略:TTL 无法保证到期前数据新鲜,版本化更精确但单点更新会牵连全部缓存;两者可叠加使用——先用精确缓存或语义缓存拦截,再让提示缓存压降低未命中请求的输入成本。
- 行业意义:文章把 LLM 缓存从“打开一个开关”拆成三项可独立测量的指标:共享前缀的复用率、相似答案的正确率、源数据的失效延迟。对自建 Agent 或客服系统的团队而言,缓存收益取决于负载结构——是否复用同一份长上下文、请求是否反复命中相似问题——而非单价本身。