JetBrains Junie Local 在 M5 Max 上编码速度提升约 70%
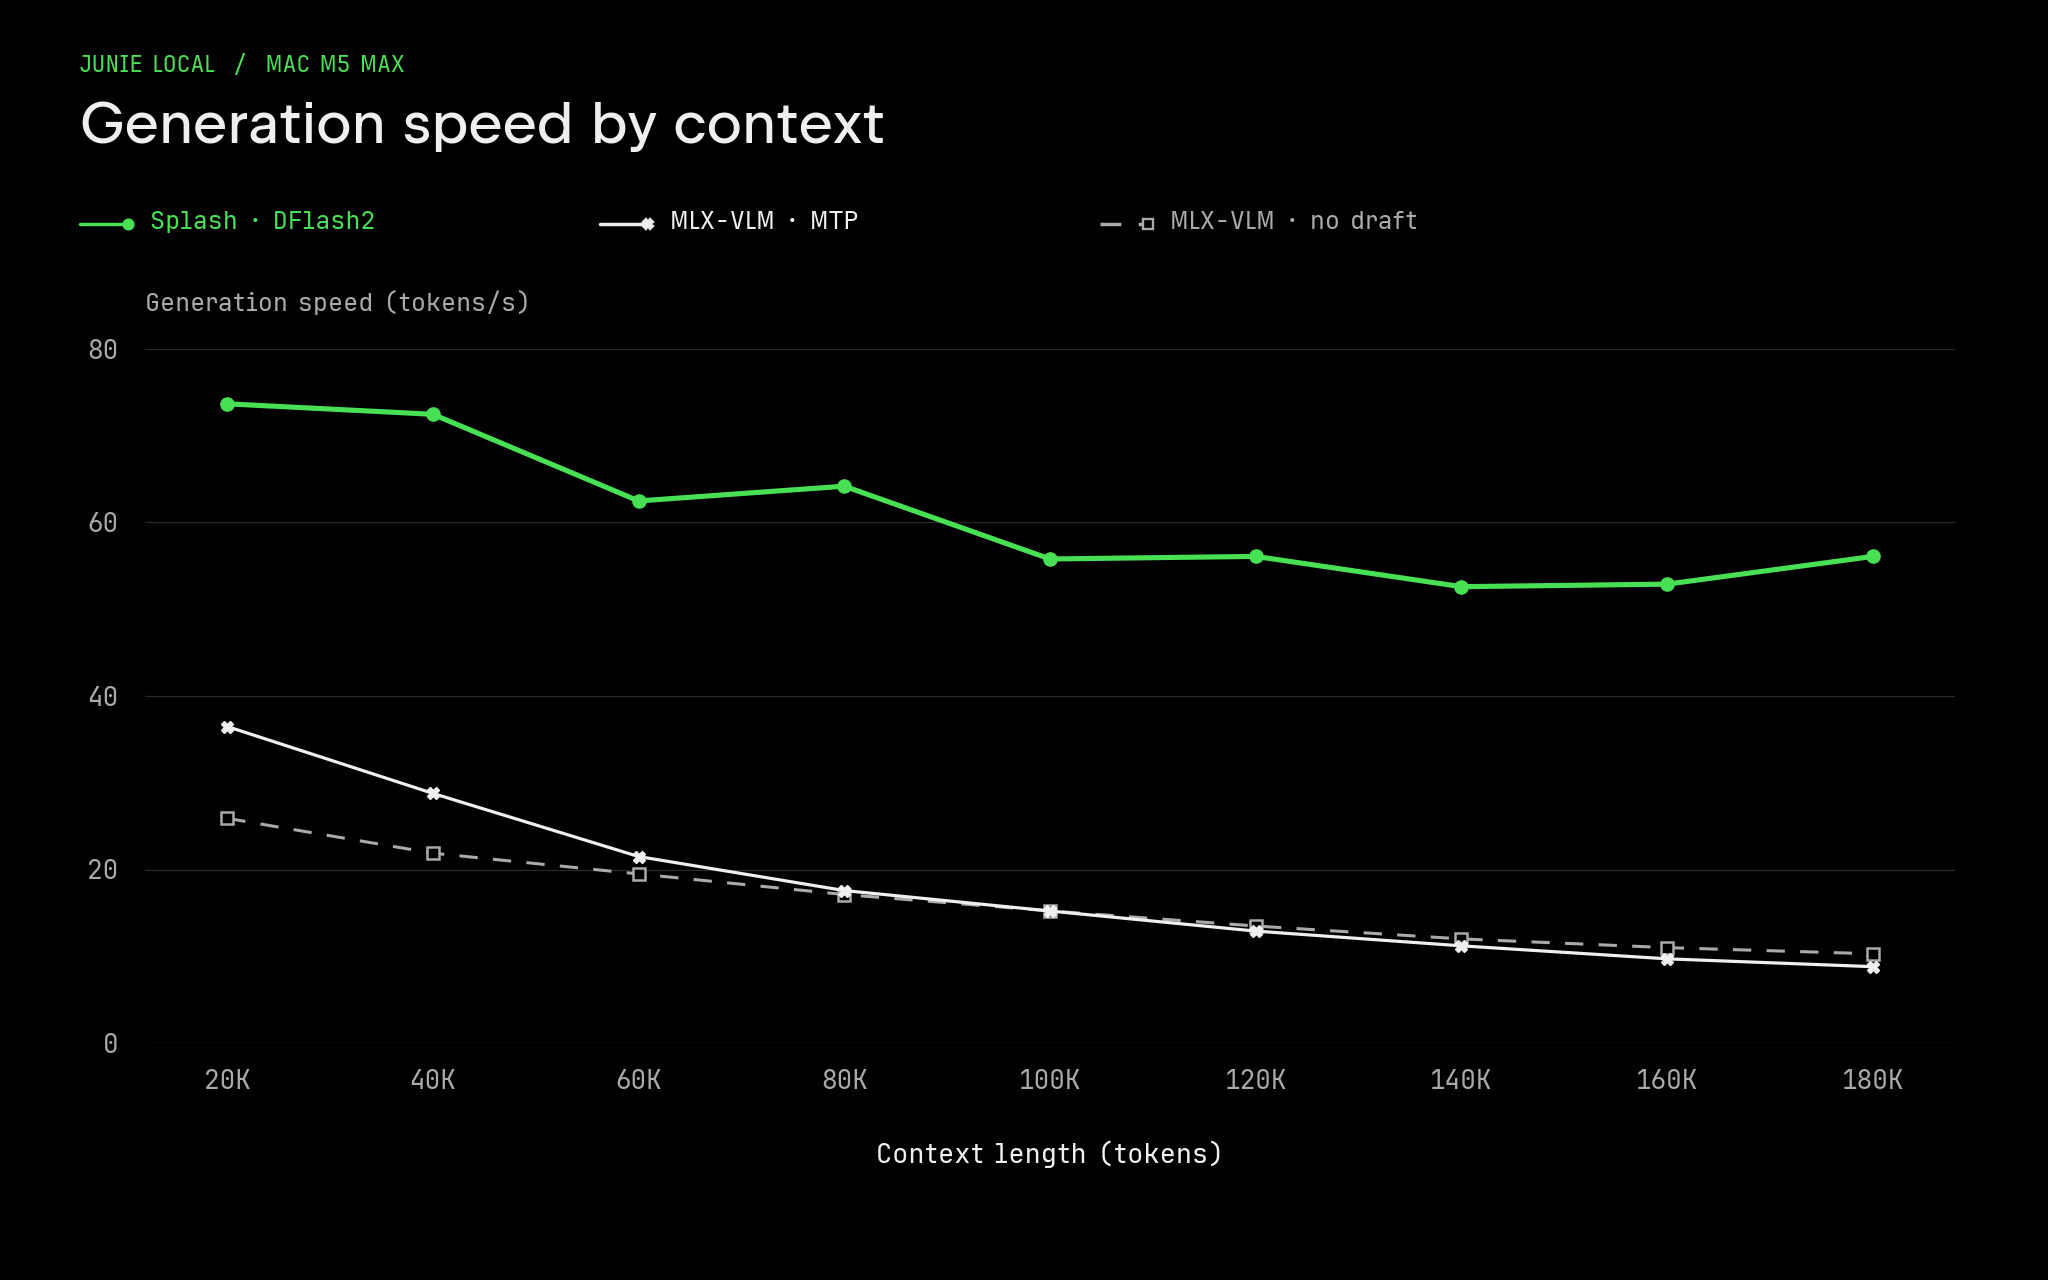
- 核心数据:JetBrains 称 Junie Local 在 M5 Max 上的编码生成速度从约 40 tokens/s 提升至约 70 tokens/s,突发可达 107 tokens/s;预填充从 850 tokens/s 提升到 1200 tokens/s。
- 两项技术改动:推理引擎由 MLX-VLM 切换为面向 Qwen 模型优化的 Splash,每个解码步骤可验证 8 个草稿 token,长上下文下解码速度下降更小;同时加入 DFlash2 草稿模型用于投机解码。
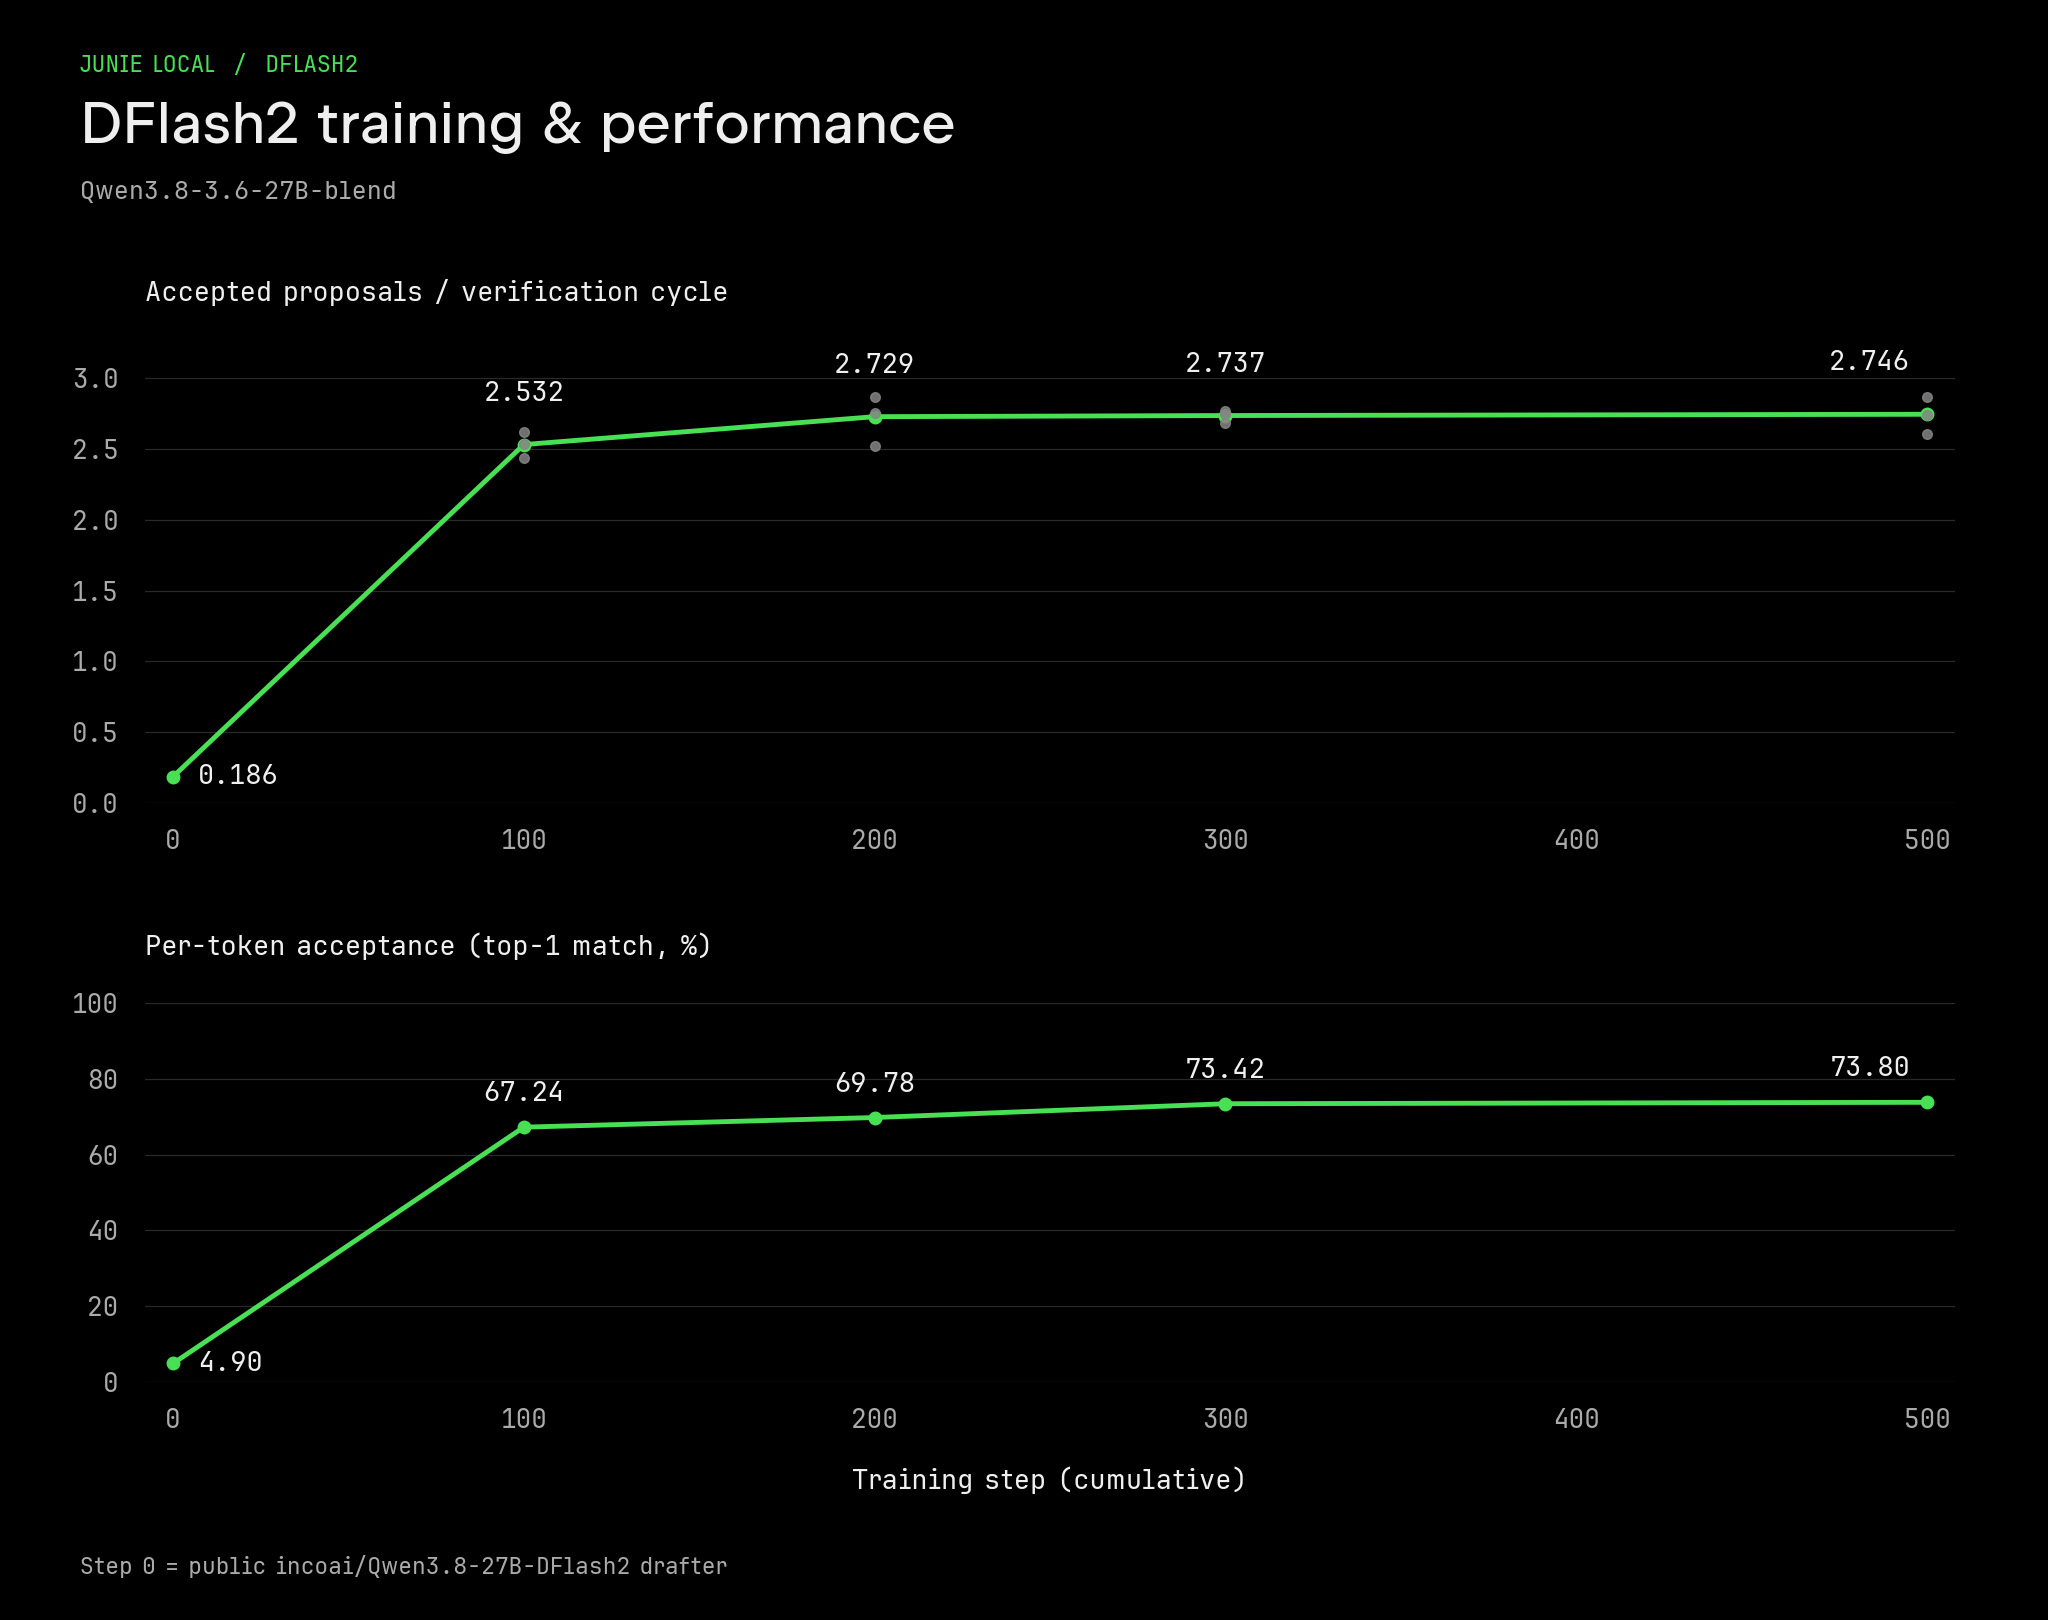
- 草稿模型训练:JetBrains 用内部编码环境生成 agentic coding 轨迹,对 Qwen 3.8 DFlash2 草稿模型做微调,并发布 Qwen3.8-3.6-27B-blend-DFlash2 与 Qwen3.6-27B-DFlash2 权重;约 100 万生成 token、读取约 7100 万 token 即达到 Inco 的接受率。
- 内存与硬件边界:100k 上下文下约需 24GB 内存;新版本支持 M4 Mac 及更新、64GB 内存设备,但 M4 上预填充约比 M5 慢 4 倍,加载系统提示和上下文会明显变慢。
- 升级方式:运行
junie update升级后,在 CLI 中执行/local并按ctrl + r更新推理引擎;未安装用户可用带--local-model的安装命令。 - 行业意义:本地编码 Agent 的性能提升不再只靠替换更大模型,而是推理引擎、投机解码草稿模型与编码轨迹微调共同作用;对在 Mac 上运行本地 Agent 的开发者,生成速度与内存占用直接决定日常可用性,但 M4 的预填充瓶颈说明硬件代际仍影响上下文加载体验。
🔗 JetBrains Blog | Qwen3.8-3.6-27B-blend-DFlash2 | Qwen3.6-27B-DFlash2