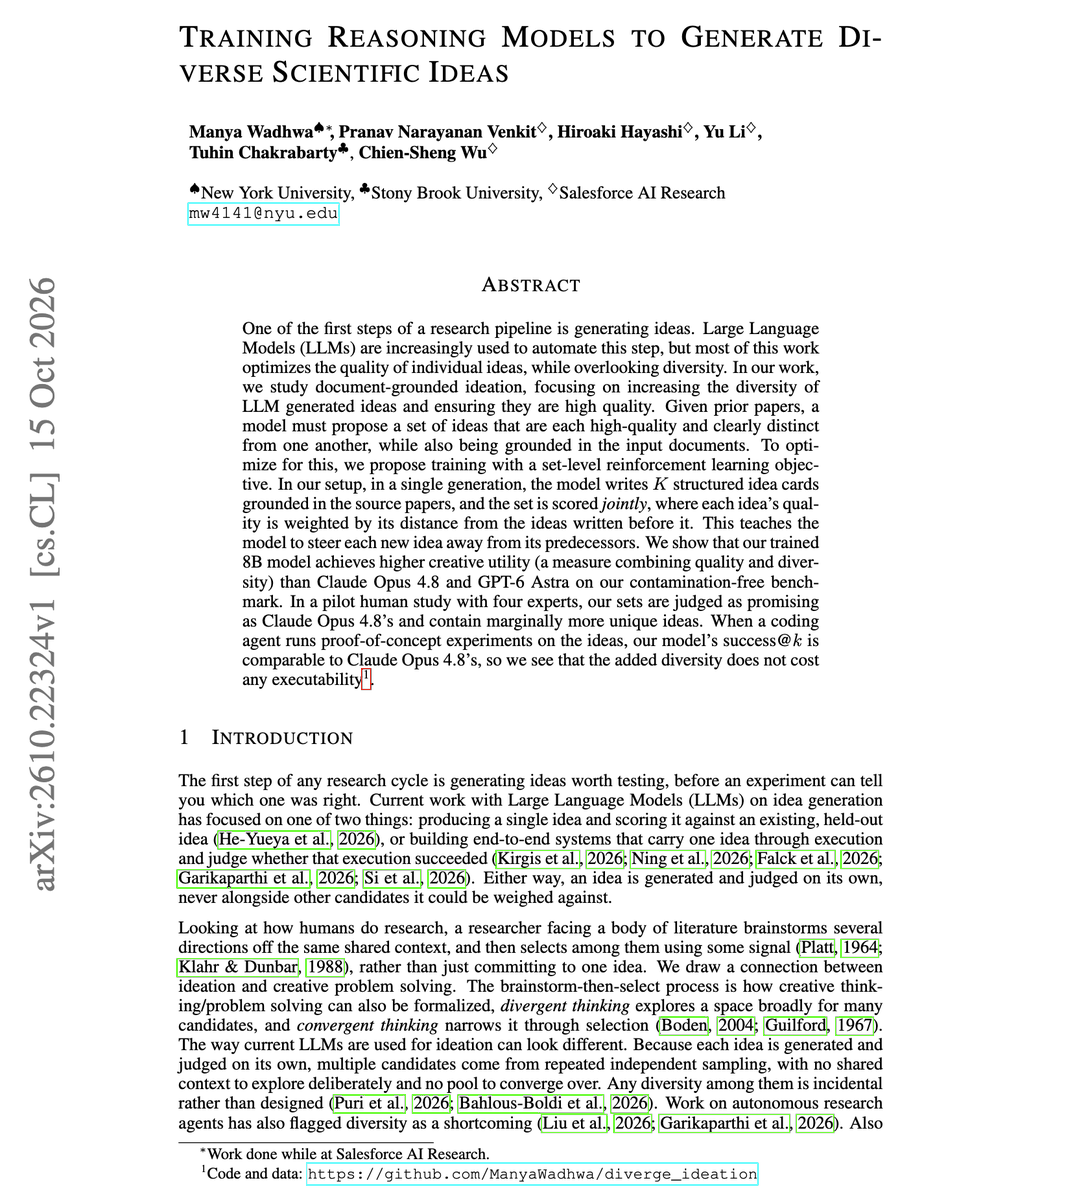
Salesforce 8B 科研创意模型在无污染基准超过 Opus 4.8 与 GPT-6 Astra
- 方法设计:Salesforce 及合作者训练一个 8B 推理模型,从一组来源论文中一次生成多个研究创意;奖励对整组创意打分,并按每个创意与前面创意的距离加权其质量,使模型学会让后续创意偏离此前方向。
- 评测结果:在团队构建的无污染基准上,该 8B 模型在“创意实用性”指标上高于 Claude Opus 4.8 与 GPT-6 Astra;该指标同时衡量创意质量与多样性。
- 问题指向:AI-scientist 流水线长期难以提出新颖且多样的研究想法,这项工作把优化对象从单条创意的质量,扩展到一组创意之间的差异度。
- 信息边界:素材来自论文页与作者推文,未披露基准规模、评分细则、基线模型版本与第三方复现结果。
- 行业观察:当奖励函数直接塑造“探索距离”,小模型在特定科研生成任务上可以通过训练目标设计取得与通用大模型不同的比较位置;其可迁移性仍取决于评测集是否覆盖真实研究流程中的筛选与验证环节。
🔗 论文 arXiv:2610.22324 | Chat with Paper | 原推文