记忆张量开源 MemT 1.0:把记忆写进模型底层架构
- 核心发布:记忆张量发布并开源 MemT 1.0 记忆原生大模型,提供 MemT-1.0-Flash 与 MemT-1.0-Nano 两个版本,代码与权重分别公开在 GitHub 和 Hugging Face。
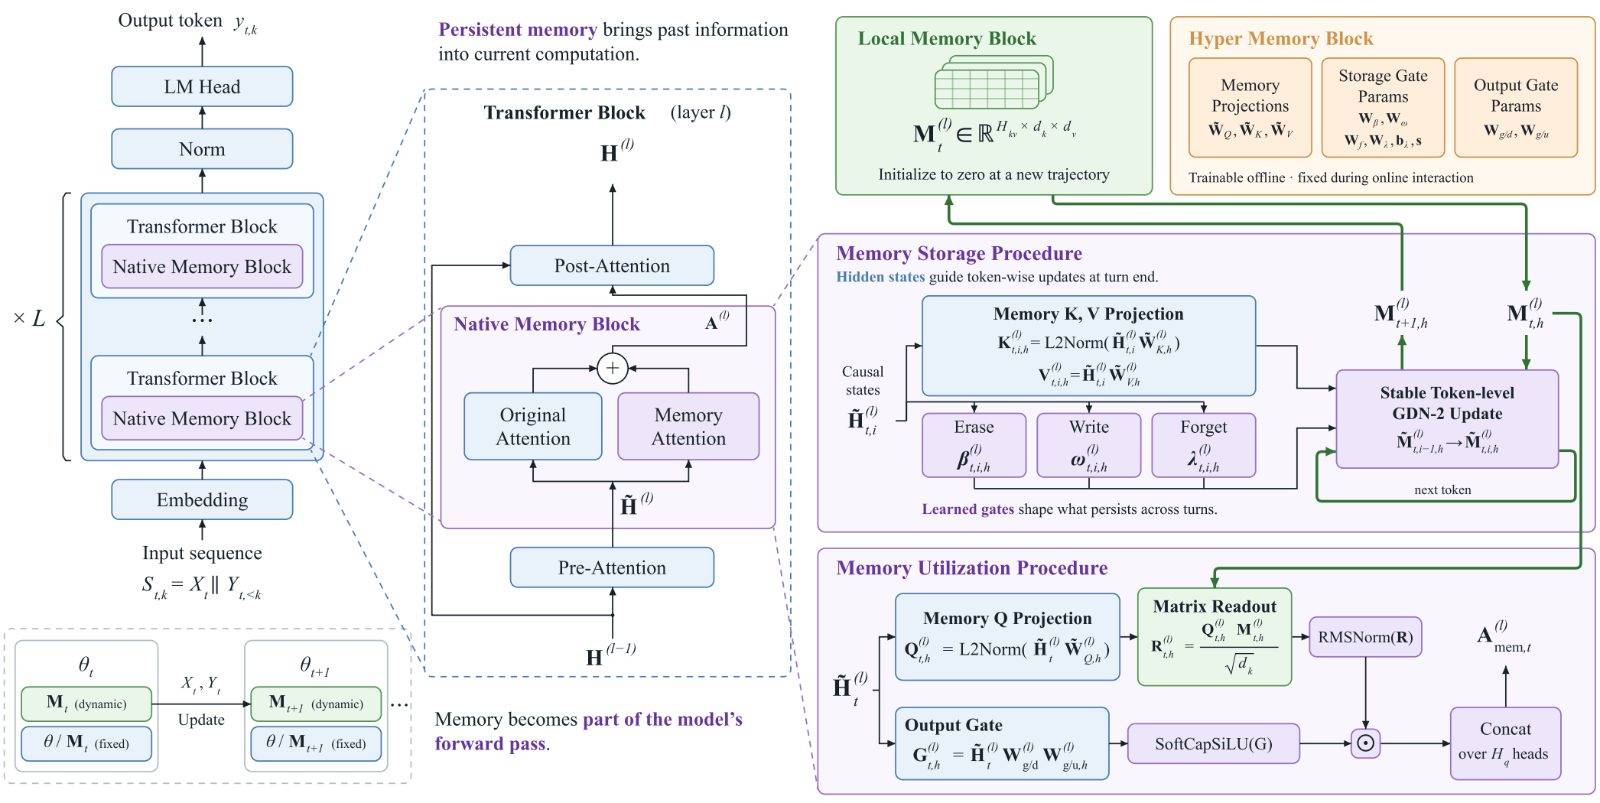
- 架构差异:与把聊天记录存入外挂检索模块的方案不同,MemT 1.0 将模型能力拆为主干网络与动态记忆状态;动态记忆状态在交互中实时演进,以固定体积参与后续每轮生成,不同用户或任务之间彼此独立。
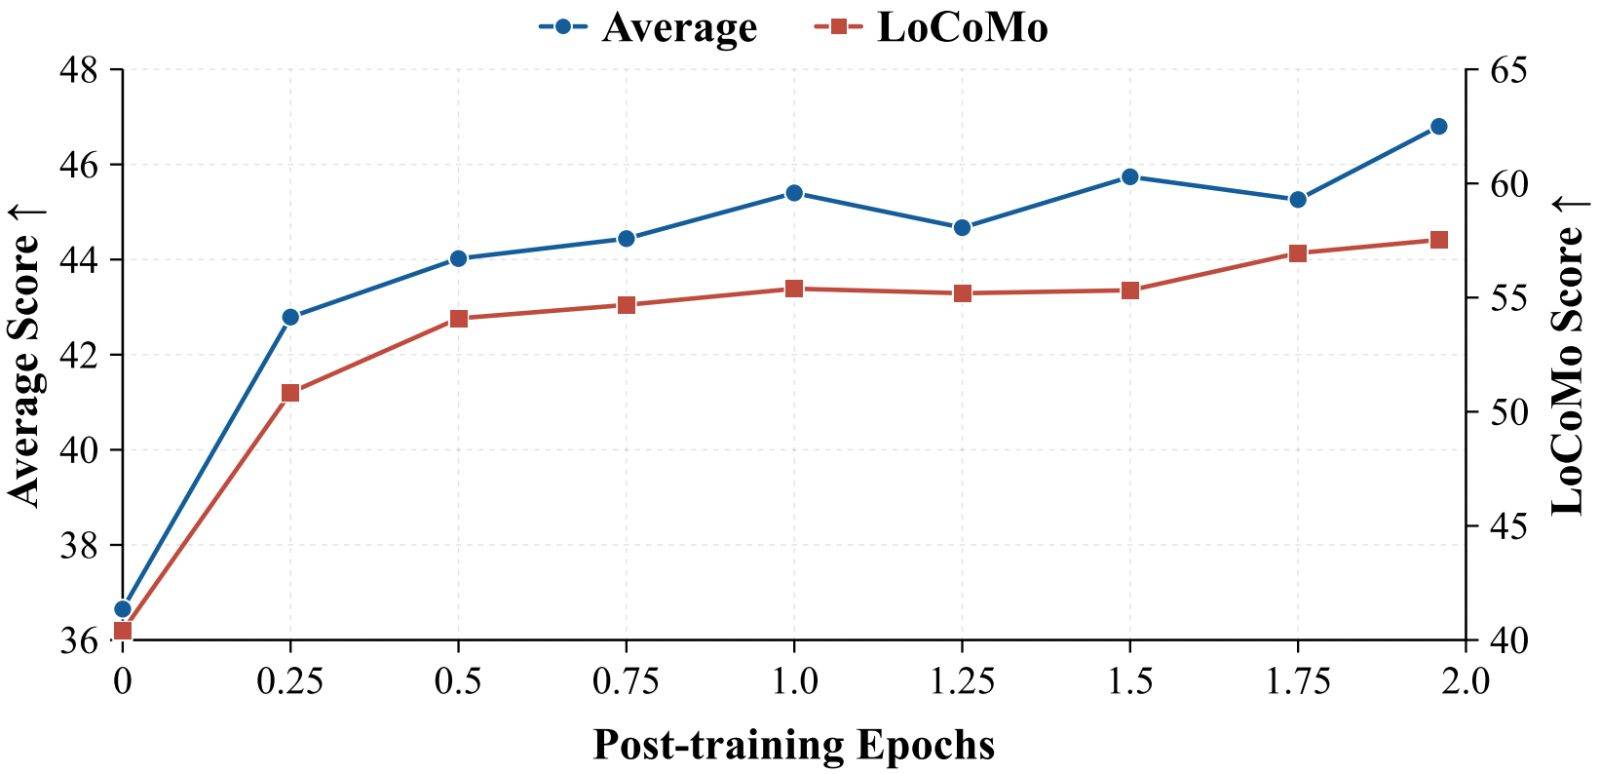
- 训练方式:团队使用 340 亿 token 分两步训练记忆机制——先用 200 亿 token 做继续预训练,让模型用过去片段预测未来;再用 140 亿 token 做后训练,由教师模型对记忆提取打分。模型通过门控机制自主决定哪些信息保留、覆盖或更新。
- 评测数据:在 11 项系统记忆基准中,全程闭卷作答的 MemT-1.0-Flash 和 MemT-1.0-Nano 均分分别为 50.6 和 47.0,官方称分别领先同组最强参数化记忆基线 12.5 分和 8.9 分。消融实验显示,拿掉后训练后 Nano 均分从 47.0 降至 36.3。
- 编程任务表现:在 SWE-bench Verified 的 500 项任务中,提前写入经验的 Nano 平均成功率从 66.07% 升至 69.33%,三次全成率从 54.00% 提至 61.60%;在实战模式下按实时反馈更新记忆状态,平均成功率 69.73%、三次全成率 62.80%。SWE-bench Multilingual 上平均成功率从 60.00% 升至 63.56%,三次全成率从 45.33% 升至 55.33%。
- 工程成本:官方称动态记忆状态体积固定,持续交互只刷新已有矩阵;在双 GPU、单并发、batch size 为 1 的条件下,处理 64K、128K、256K token 历史时,Nano 相对完整上下文方案的端到端推理速度分别约为 1.20 倍、1.86 倍和 3.99 倍;128K 历史下恢复单条交互历史所需的持久状态存储约为完整上下文 KV cache 的六十六分之一。
- 行业意义:记忆从外挂检索模块转为模型内部状态后,长周期对话与 Agent 任务的经验复用、上下文成本结构可能出现变化;但当前评测与效率数据主要来自发布方,实际泛化能力仍需第三方复现与更多任务验证。 🔗 爱范儿报道 | GitHub | Hugging Face