SageMaker AI 训练会话正式可用:算法留给用户,GPU 交给平台
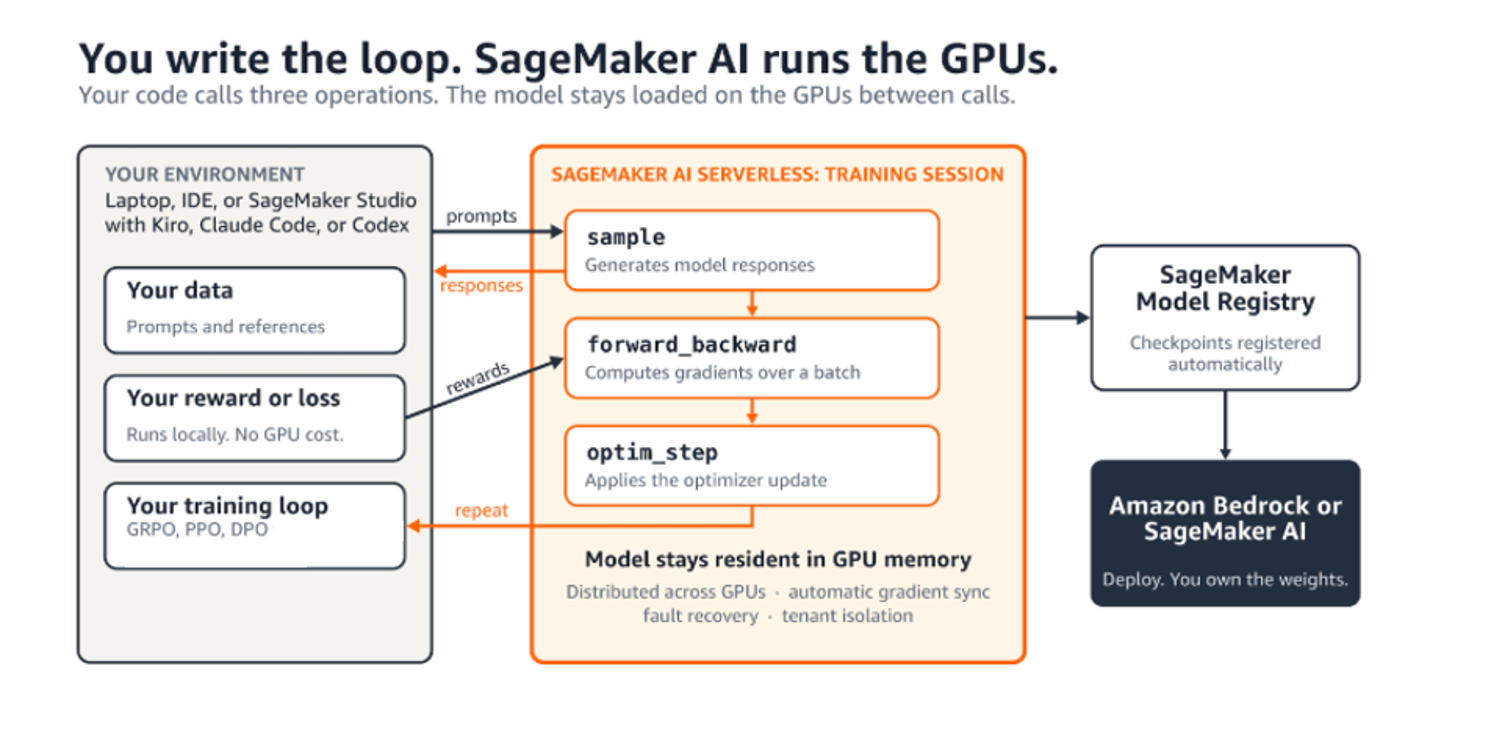
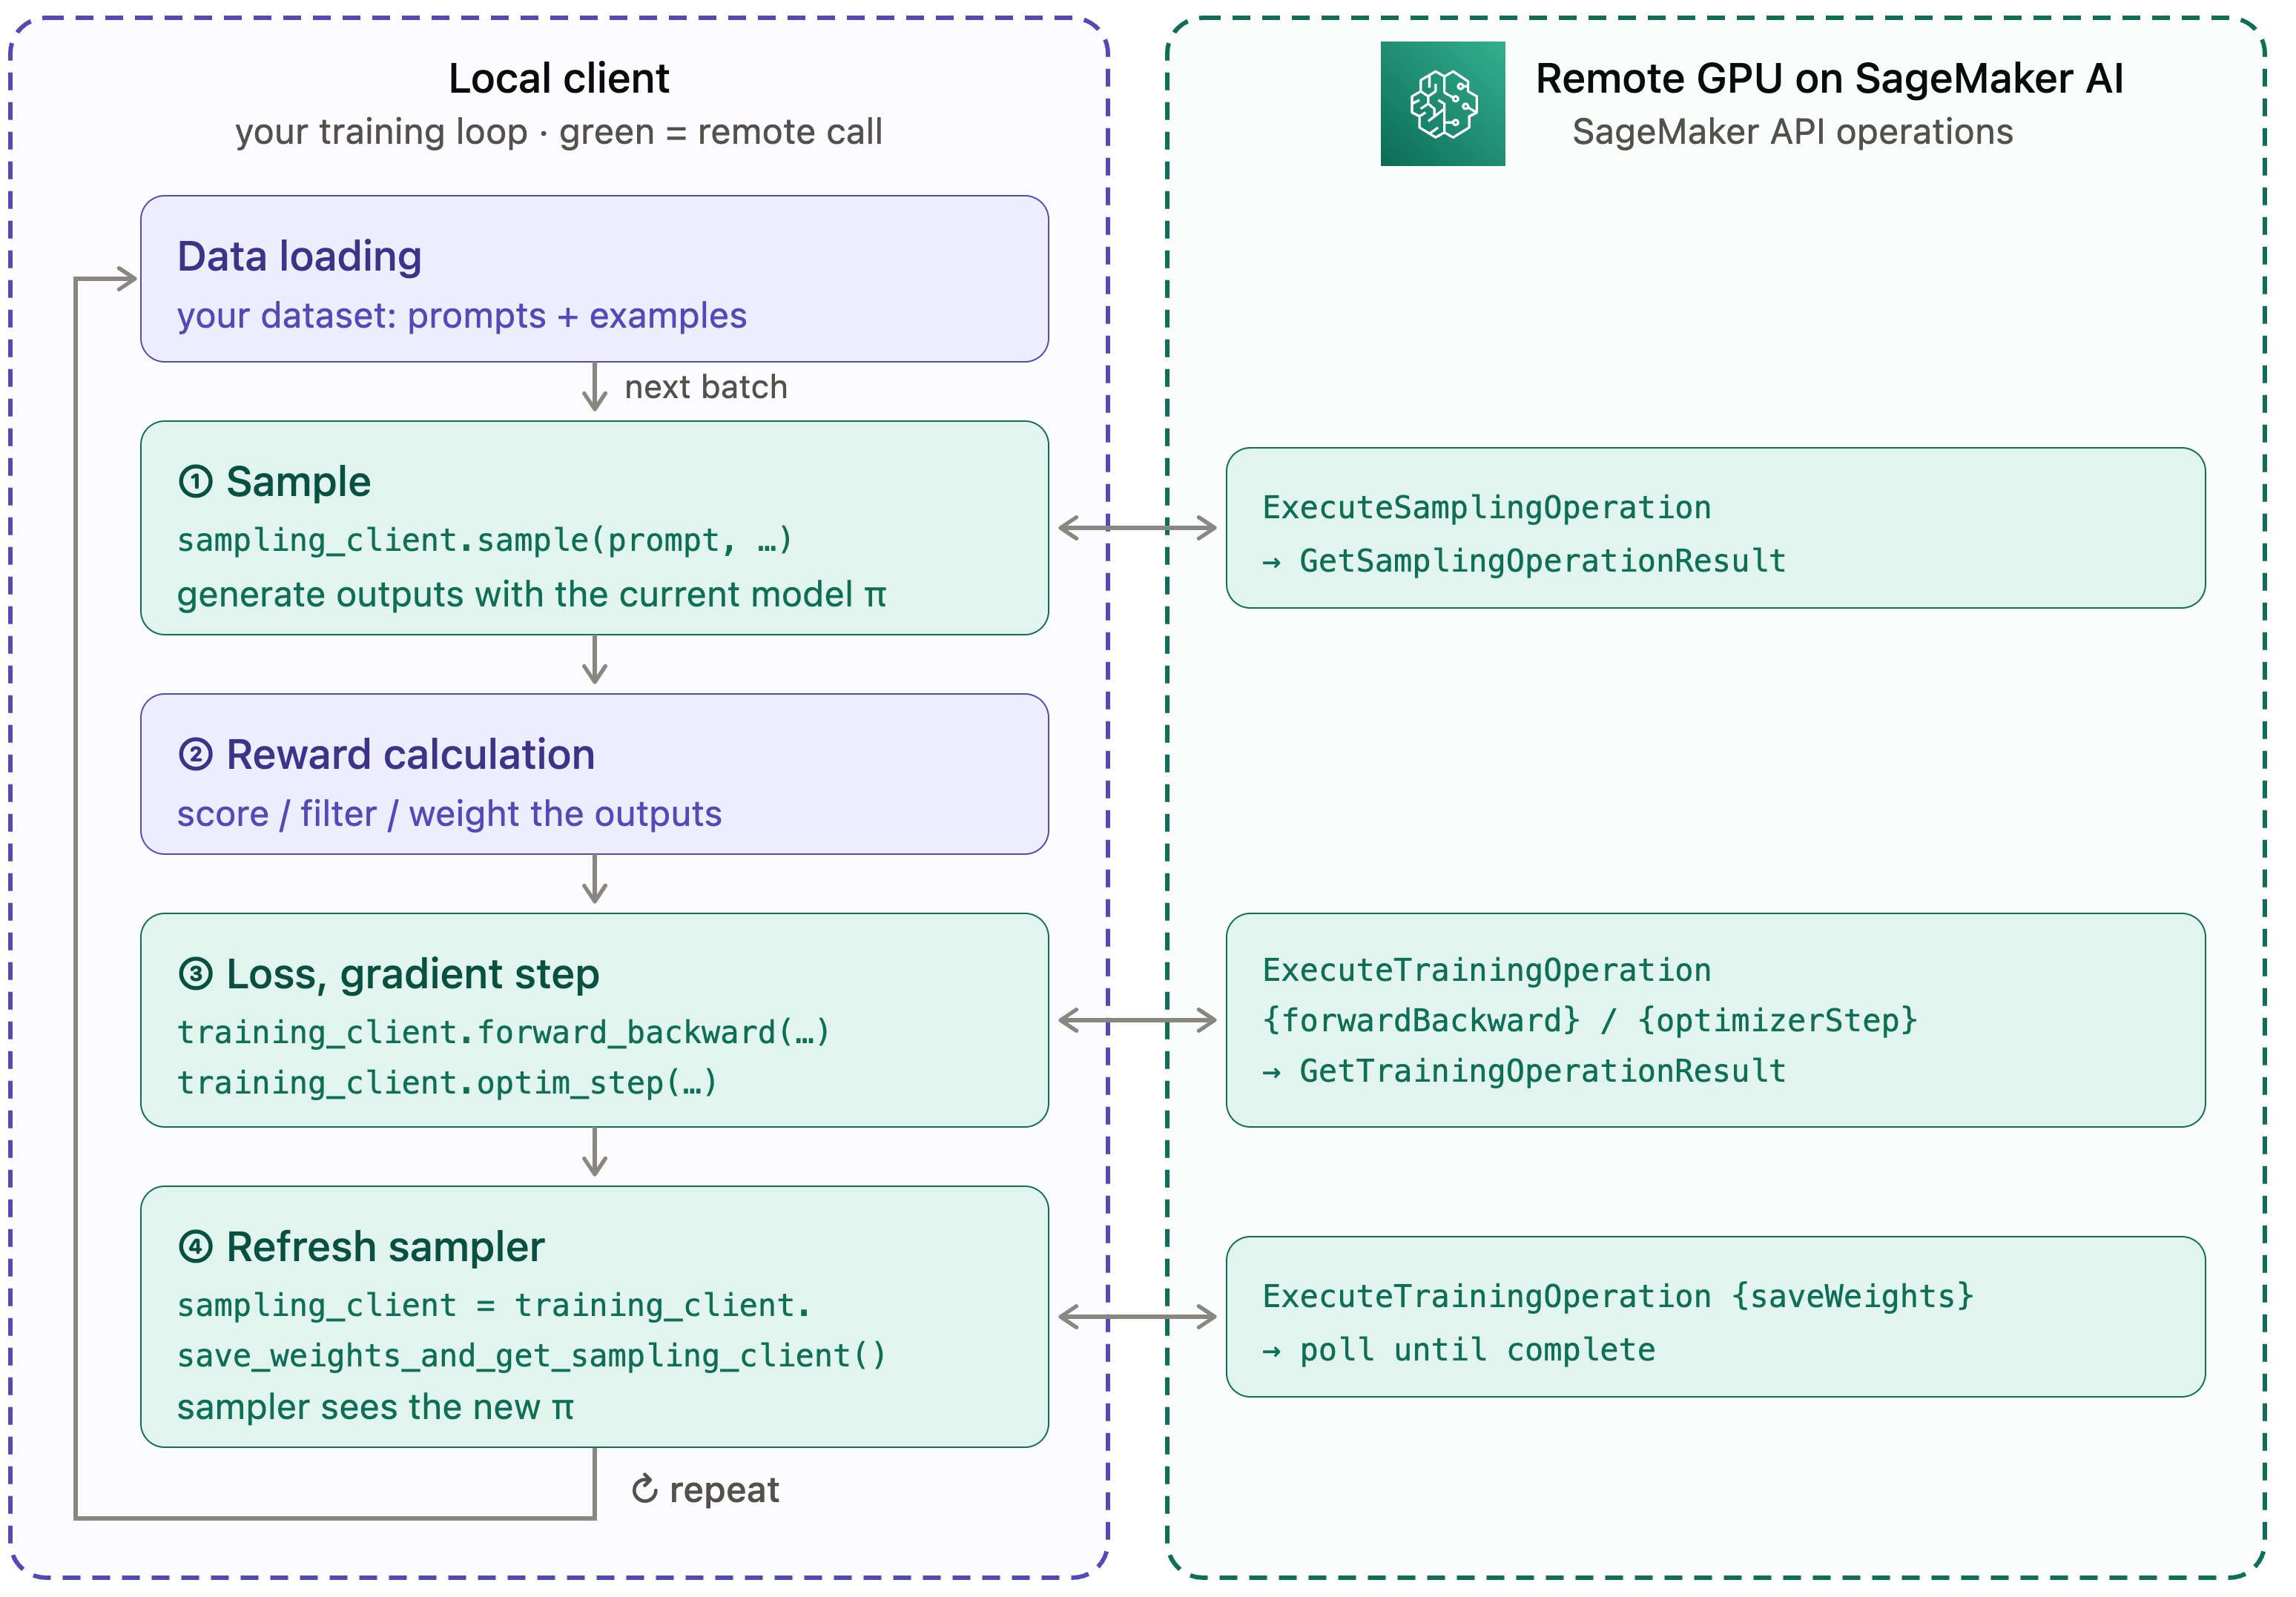
- 核心发布:亚马逊云科技宣布 SageMaker AI 无服务器模型定制新增 training sessions 正式可用。用户编写并协调训练循环,包括自定义损失函数与奖励信号;平台负责 GPU 分配、分布式执行、故障恢复与检查点存储。
- 编程接口:
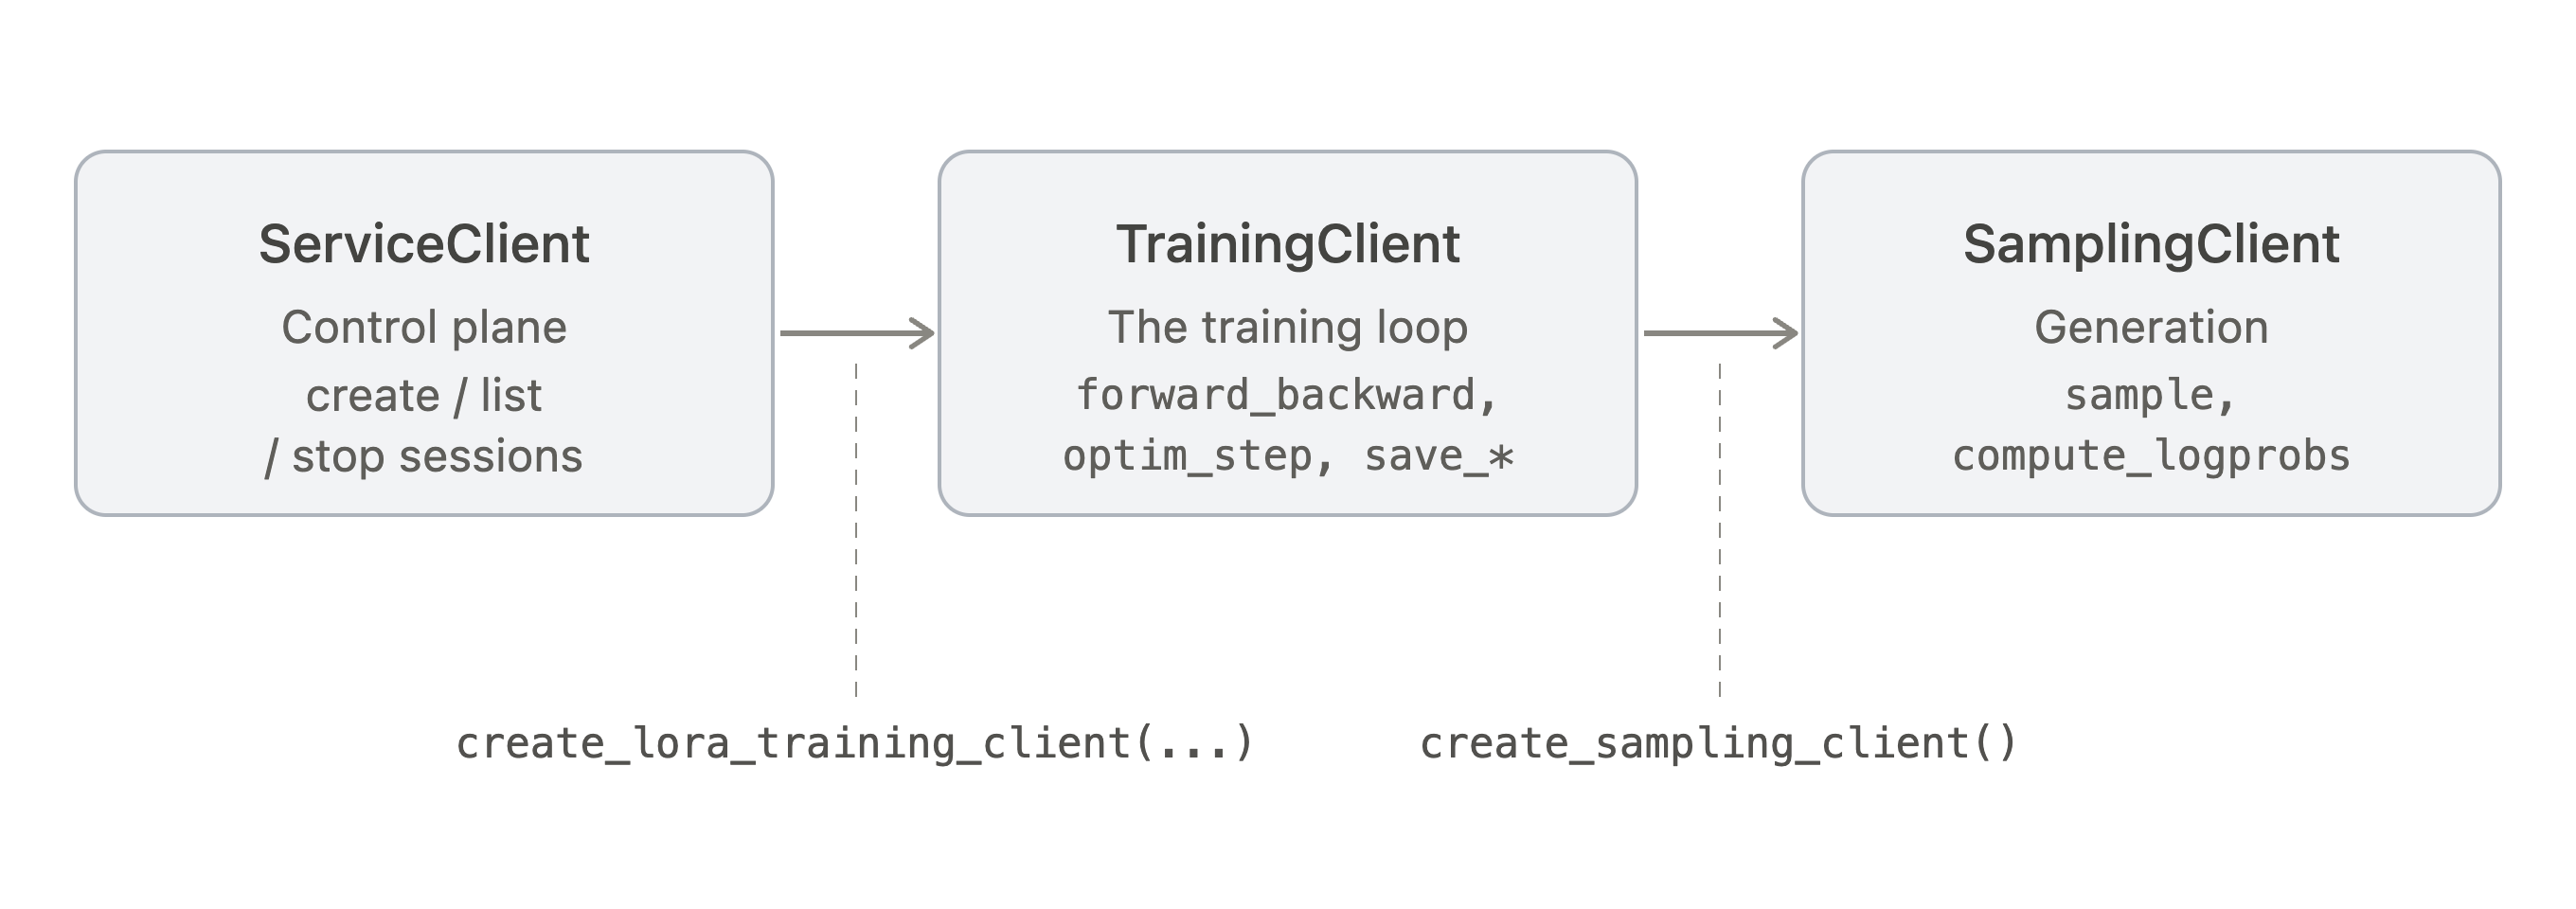
forward_backward()、optim_step()、sample()等操作被封装为 SageMaker API 调用,针对一个有状态会话执行——模型在整个训练过程中常驻 GPU,调用次数由用户代码控制。SDK 由 ServiceClient、TrainingClient、SamplingClient 三层构成,采样客户端同时提供 OpenAI 兼容的 chat completions 端点。 - 技术覆盖:支持 SFT、DPO、RLVR、RLAIF 与多轮 RL;可选 LoRA 或全参数微调,并可通过连续定制将多种技术串联。初始支持
gpt-oss-20b、gemma-4-31B-it、Qwen3.6-27B、Qwen3.8-27B。 - 计费方式:按处理的 token 计量,reward 函数在本地运行时停止计费——奖励计算、数据加载与日志记录不占用 GPU 时长。
- 实测数据:官方示例中,GPT-OSS 20B 在 GSM8K 上 10 步训练将留出集准确率从 56% 提升至 75%;Code RL 配方在竞争性编程任务上训练 50 步,训练奖励从 0.46 升至 0.60,200 个留出测试问题准确率从 40% 升至 50.5%。
- 配套开源:同步发布 SageMaker training sessions cookbook,包含 SFT 与 RL 的可复用训练循环配方。
- 行业定位:在 SageMaker 的模型定制谱系中,training sessions 位于"完全托管的预设配方"与"完整控制但自管基础设施的 Training Jobs/HyperPod"之间——算法自由度接近后者,运维负担接近前者。