Property Finder 重建无偏评估:Bedrock 选型准确率提升、成本降 86%
- 问题发现:Property Finder 的视觉 AI 评估集中,96.8% 标签直接继承自现有 VLM 的预测,而非人工核验;任何替代模型都会先被按“与 incumbent 的相似度”衡量。剩余人工标签还存在类别越界与字符级错误。
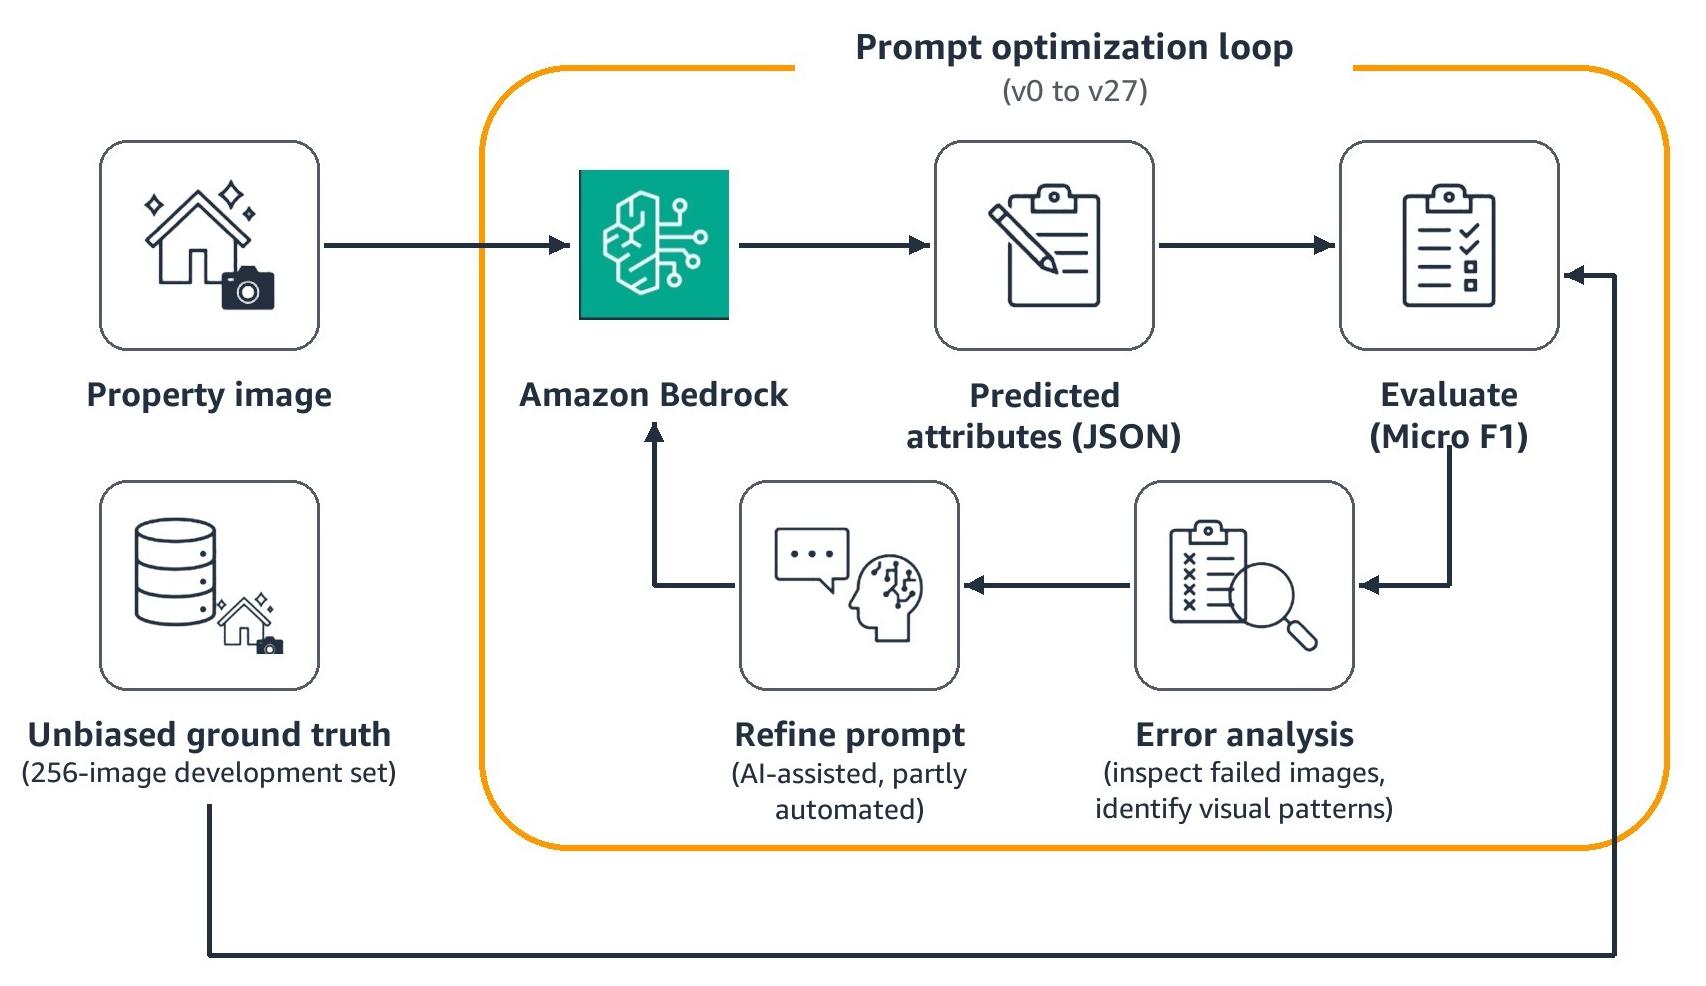
- 重建基准:团队对 356 张 UAE 房产图像做领域专家独立标注,转向多标签分类,并以 Micro F1 为主指标,辅以 Macro F1、逐标签精确率/召回率、IoU 和单标签精确匹配诊断。
- 模型与提示优化:以共享 v21 多标签提示为起点,分别调优候选模型;Llama 4 Maverick 17B Instruct 经 v24-v27 与 MIPROv2 优化后,在 356 张评估集上 Micro F1 达 0.80,专有模型 A 为 0.56;开发集上从 0.55 升至 0.81。
- 成本与延迟:单次调用处理全部 11 个属性,估算每 1,000 张图像成本 2.35 美元,较原设置降 86%;生产监控显示推理延迟下降 40%–60%。
- 行业意义:这条案例把模型选型的瓶颈定位到“评估标签由 incumbent 模型生成”的循环偏差;对准备切换视觉模型的团队,先重建领域专家 ground truth、保留独立测试集,再谈提示优化与成本,才具备可比性。多标签化也避免把门景中的第二个房间等合理预测误判为错误。 🔗 AWS Machine Learning Blog