AWS 发布 Ray Train DLC 参考架构:EKS 多机训练把镜像构建移出关键路径
- 核心发布:AWS 公布一套基于 Ray Train 深度学习容器(DLC)的多机训练参考架构与示例仓库,用公开镜像
public.ecr.aws/deep-learning-containers/ray:train-ml-cuda-v1.1在 Amazon EKS 上完成 Qwen2.5-1.5B 的 PyTorch FSDP 微调,全程不构建、不推送任何自定义镜像。 - 镜像内含的依赖栈:该 tag 打包 Ray 2.58.0(含 Train/Tune/Data)、PyTorch 2.13.0、CUDA 13.0.2、NCCL 2.29.7、EFA 用户态库与 AWS OFI NCCL 插件、GDRCopy,以及 DeepSpeed、flash-attn、Transformer Engine、PyTorch Lightning 与 Hugging Face 训练库;
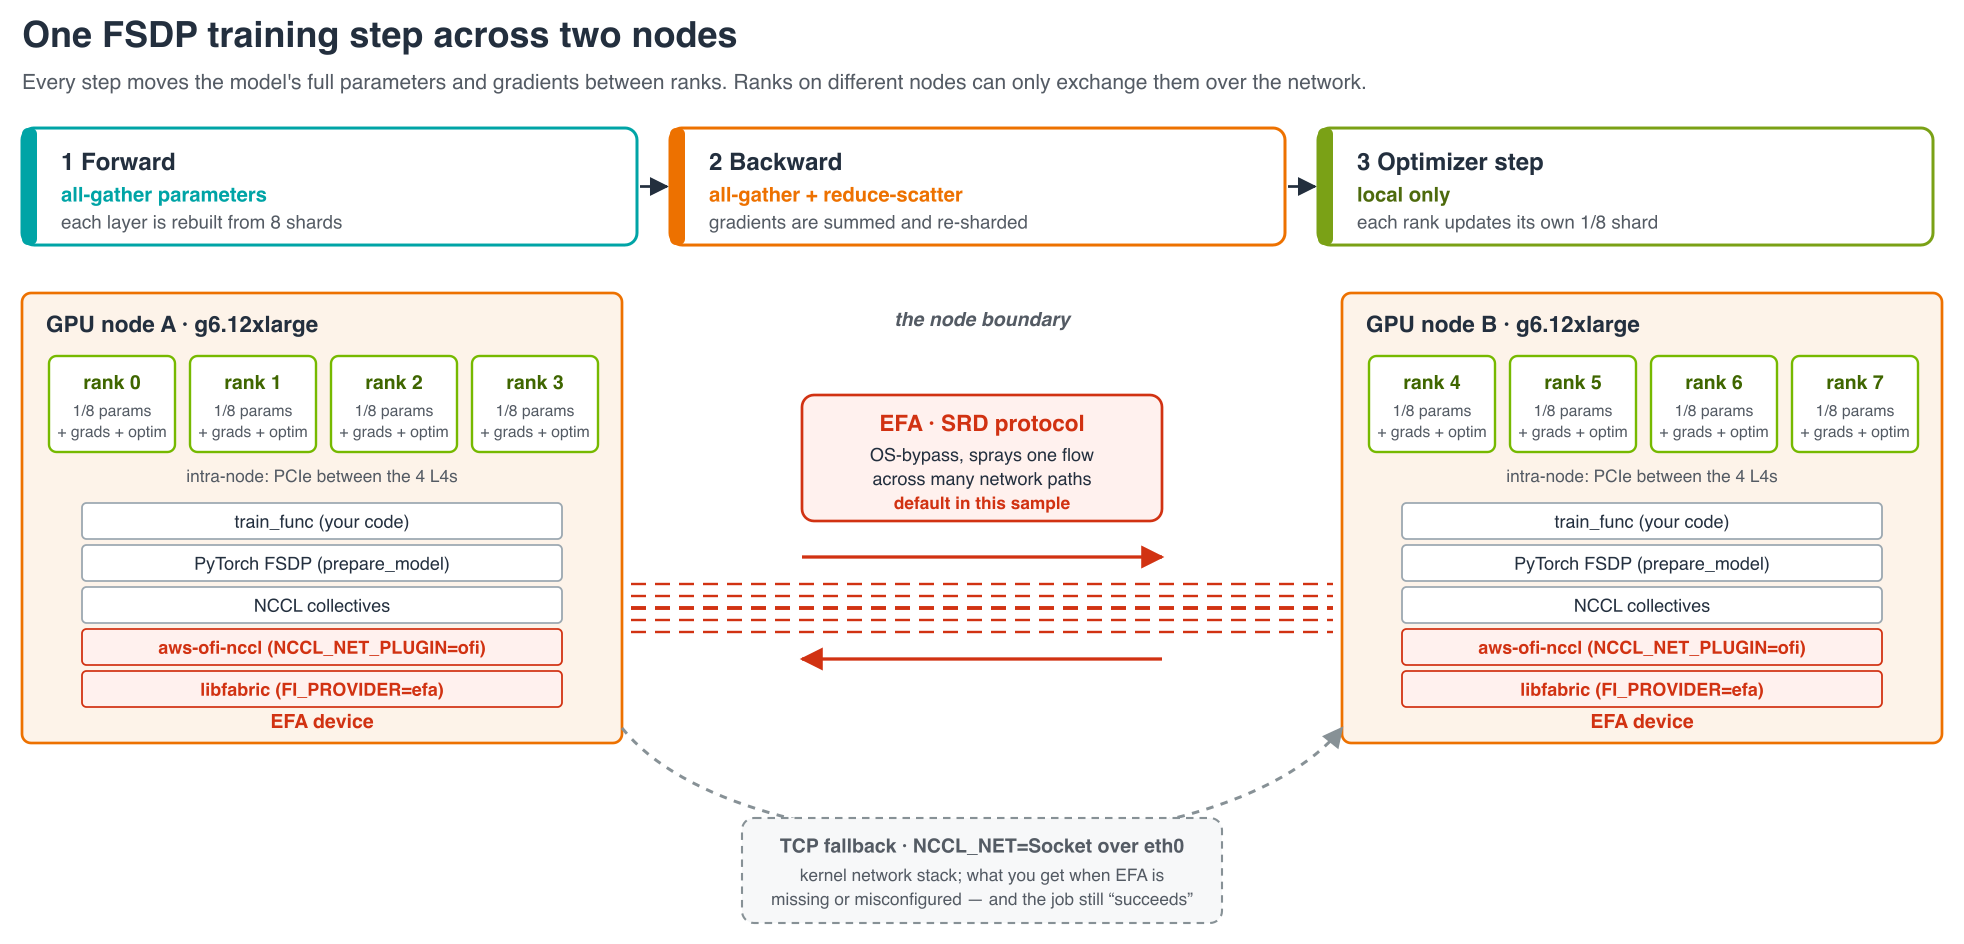
all_reduce_perf已预置在 PATH 上。AWS 称每次发版都在多机 EFA 与多机 KubeRay 两条路径上做过闸门测试。 - 关键的失效模式:文章明确指出网络栈版本错配不会报错——NCCL 会静默降级到 TCP socket,任务照常跑完,只是速度降到零头。这是把 CUDA/NCCL/EFA 三层编译对齐交给镜像维护方的直接理由,也说明此类性能退化在自查中难以发现。
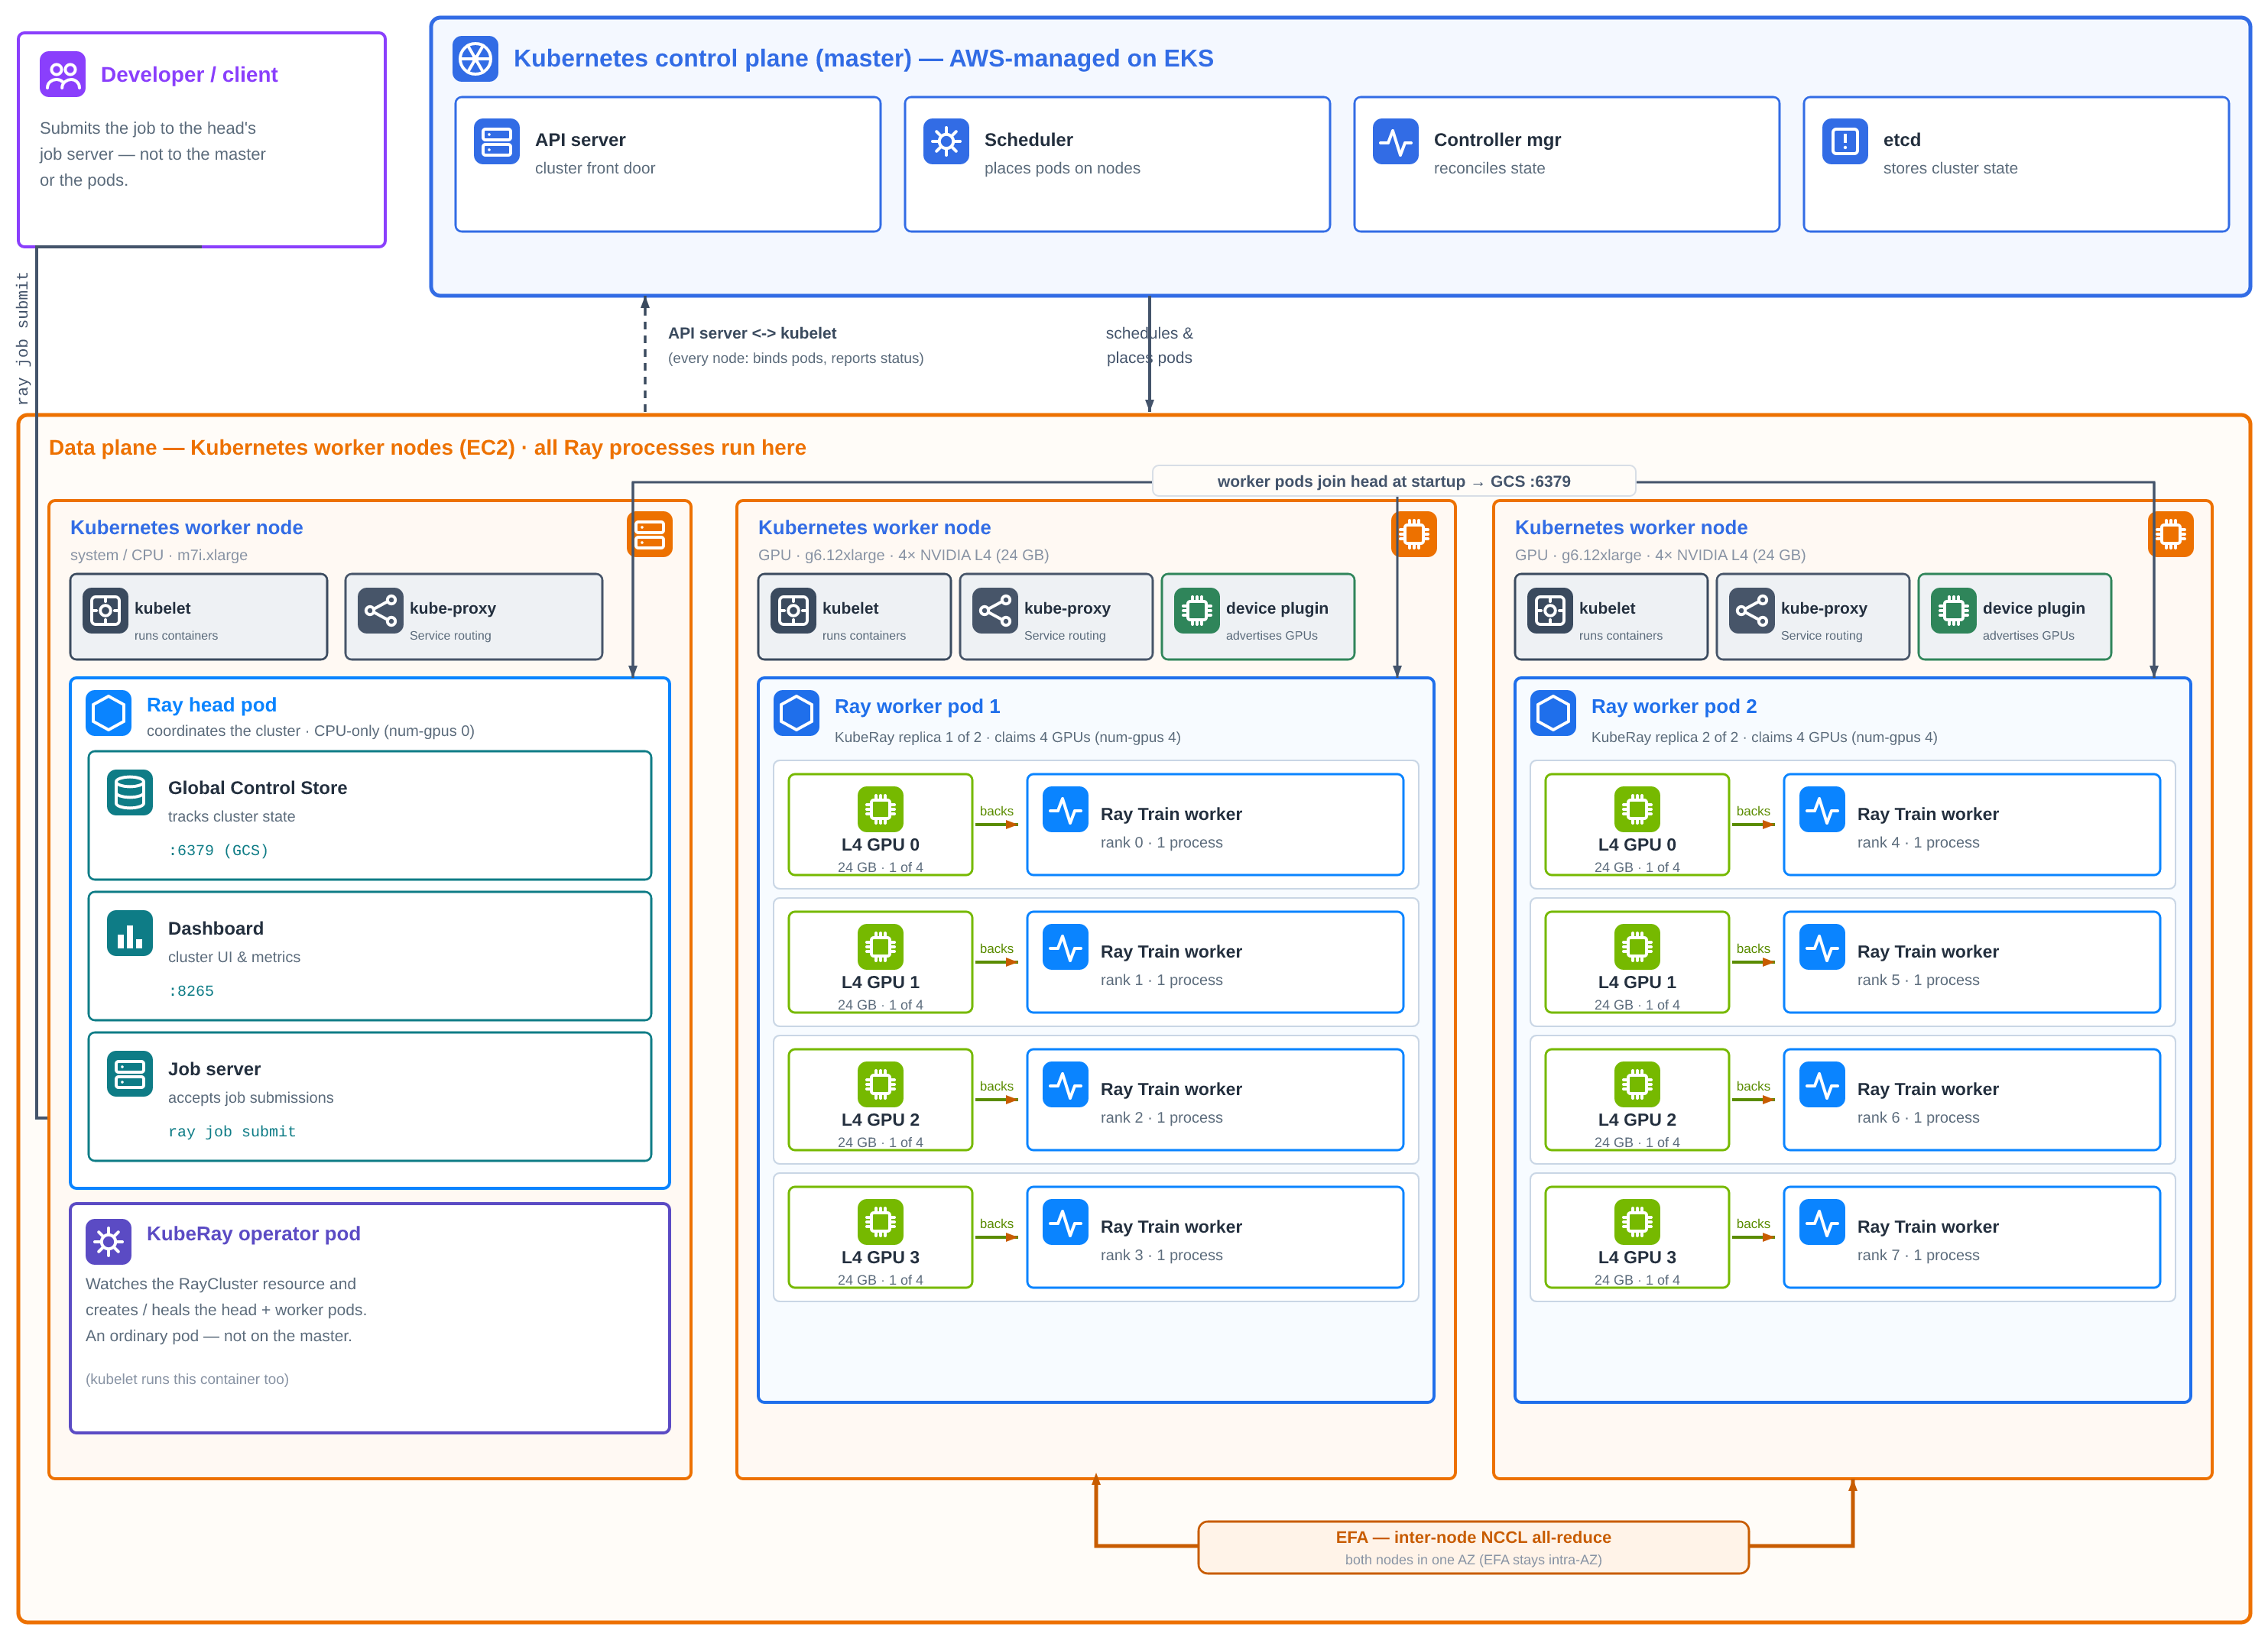
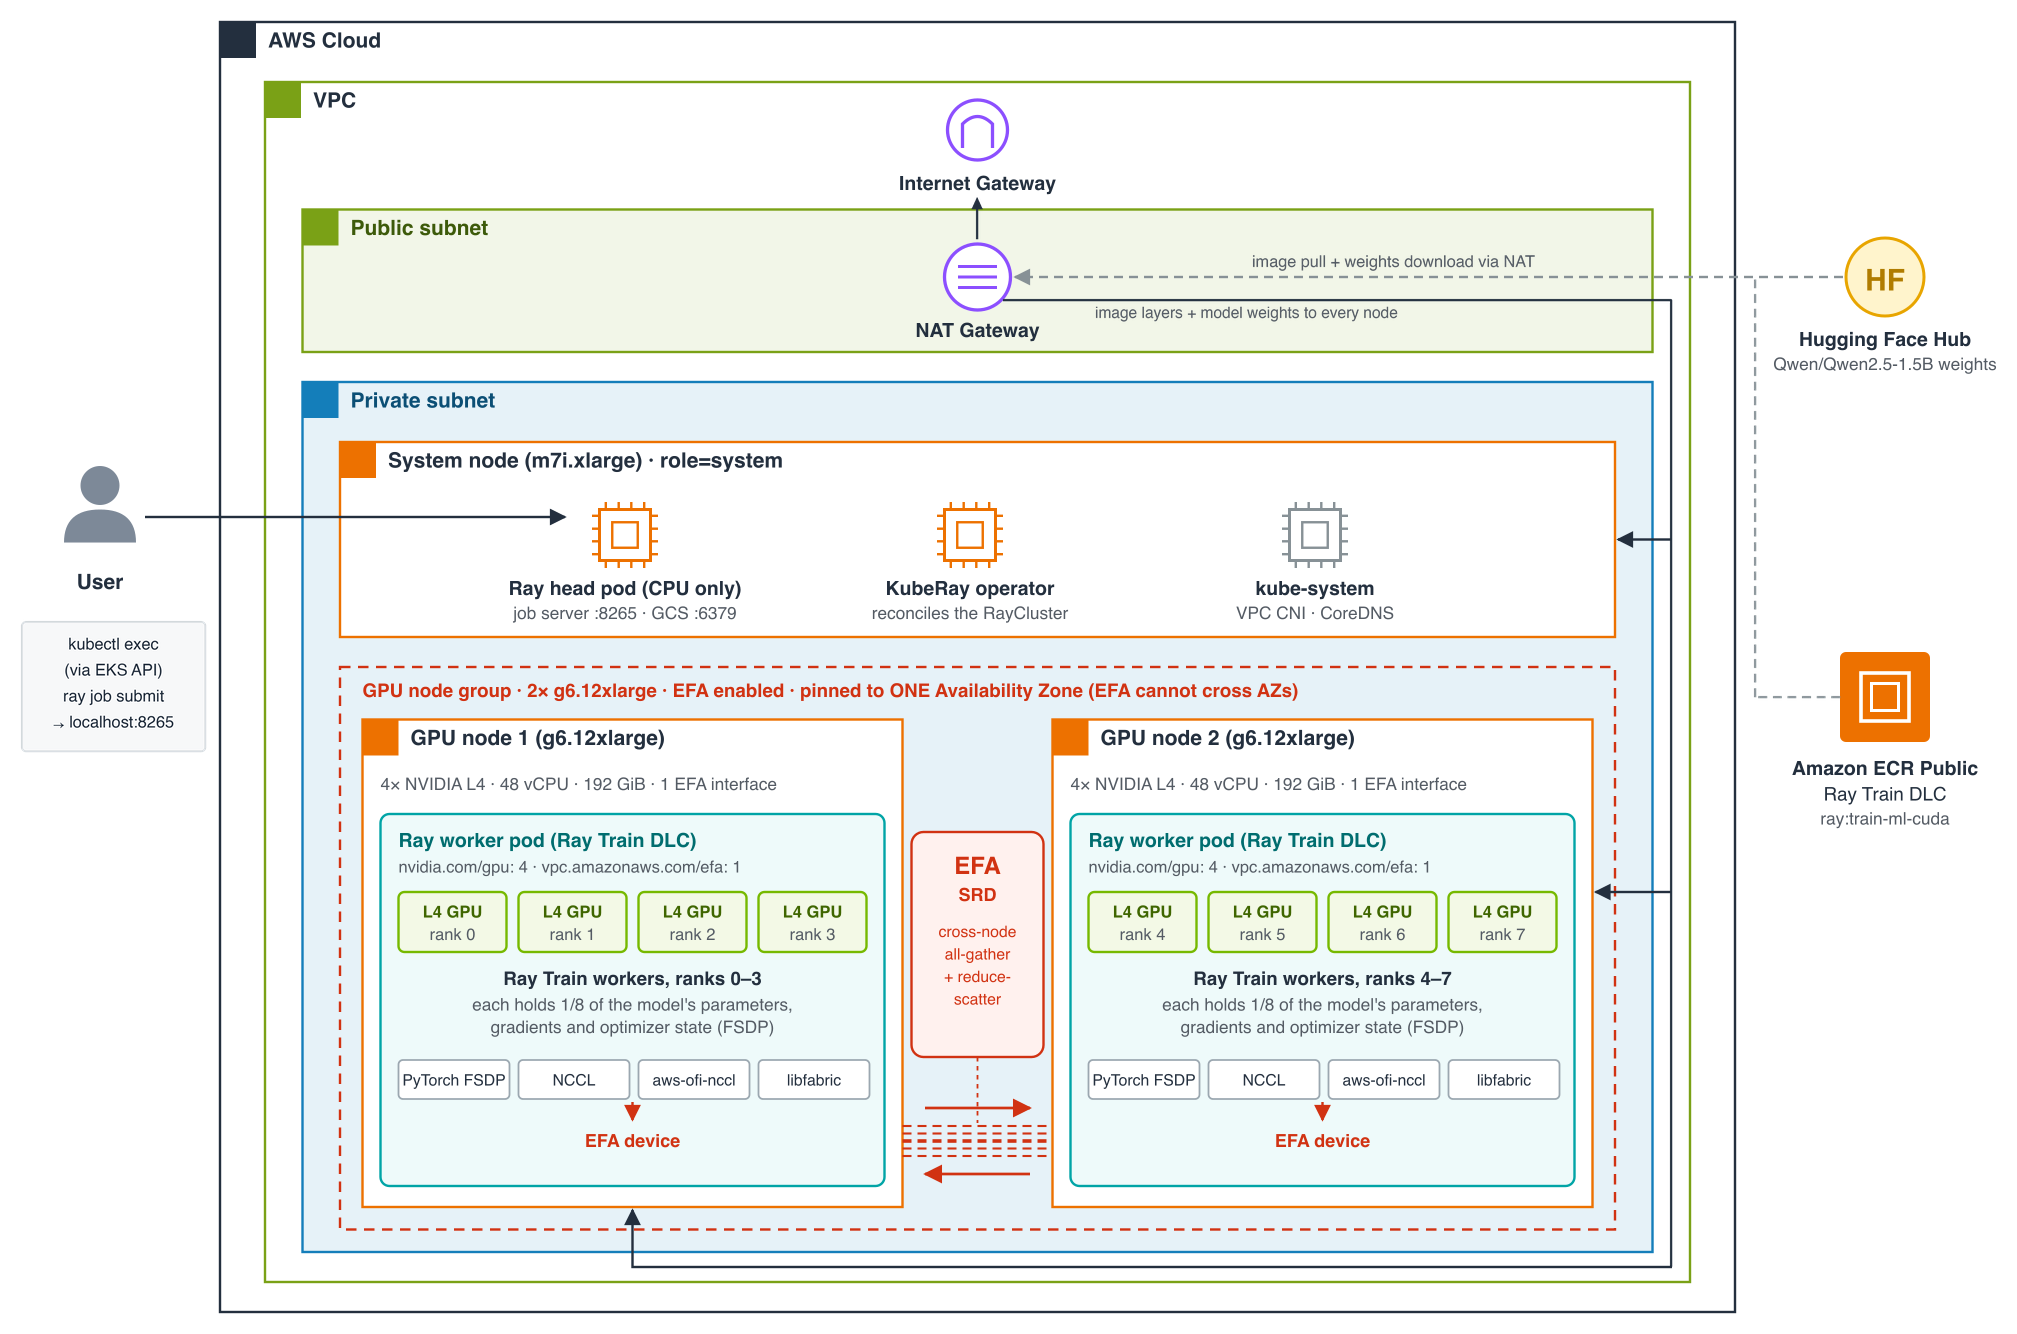
- 集群布局:一台 m7i.xlarge 系统节点承载 KubeRay operator 与不占 GPU 的 Ray head(仅跑 job server 8265 与控制存储 6379),两台 g6.12xlarge 各带 4 张 L4 与 1 个 EFA 接口,各跑一个申领全部 4 卡与 EFA 的 worker pod,Ray Train 把 8 个 rank 铺在两台机器上。文档标注 GPU 实例与控制面、NAT 网关合计约每小时 9.50 美元,全新 Region 上四步部署约 20–30 分钟。
- 配置全部在镜像之外:角色由 KubeRay 的
rayStartParams区分,GPU 与 EFA 通过 Kubernetes resource requests 申领,传输层由FI_PROVIDER、NCCL_NET_PLUGIN、NCCL_SOCKET_IFNAME、NCCL_DEBUG四个环境变量显式指定而非依赖自动探测,额外 Python 包走 Rayruntime_env在提交时安装,版本用vX.Y或 digest 固定以复现。 - 两个容易被忽略的部署细节:其一,只有显式请求
vpc.amazonaws.com/efa,EFA device plugin 才会把接口挂进容器,否则 NCCL 看不到 EFA;其二,worker 节点需要nvidia.com/gpu.present=true标签,缺失时 NVIDIA device plugin 的 DaemonSet 会落在零个节点上且不报错。此外 requests 与 limits 相等以进入 Guaranteed QoS,避免单个被限流或驱逐的 rank 拖住其余七个。 - 训练与编排代码:训练循环是一个
train_func,通过ray.train.torch.prepare_model(parallel_strategy="fsdp")按参数量(>1000 万)自动切分 FSDP 单元,保持脚本与模型结构解耦;driver 用ray.cluster_resources()读取 GPU 数决定 worker 数量,因此同一份脚本在单机与多机间不改代码。示例用随机 token ID 作为输入,只验证 FSDP 集合通信确实跨了两台机器。 - 交付脚本的取舍:
deploy_all.sh先在候选 Region/AZ 间探测 g6.12xlarge 的实际容量(可选--probe通过创建并立即取消真实 Capacity Reservation 取得确定答案),再把选定位置写入.placement.env供后续脚本读取;deploy_ray_train_job.sh会检查 NCCL 实际使用的传输路径,若 EFA 未进入链路则直接报错退出,因此可当作 CI 闸门使用。 - 边界:这是参考架构与可运行示例,公开信息只给出「四条环境变量接入 EFA 后相对 TCP 吞吐翻倍」这一对比,未披露完整基准、真实数据集上的收敛表现与长周期运行稳定性;训练代码中的随机张量也意味着它验证的是链路而非模型效果。
- 行业意义:分布式训练的启动成本长期落在容器栈的版本对齐上,而不是模型代码本身;这套方案把 CUDA、NCCL、EFA、Ray 的兼容性收敛到 AWS 维护的单一 tag,把可变项压到 manifest 与环境变量。对自建多机训练平台的团队,更值得复用的是两条判断——把网络传输显式声明而非交给自动探测,以及对 NCCL 是否真的走了高速链路做可失败的校验。
🔗 AWS Machine Learning Blog | 示例仓库