Reflection Beam 上线 AWS:JumpStart 实时端点与 HyperPod 三条部署路径
- 前情提要:Reflection AI 已发布其首个开源权重模型 Beam,501B 总参数、23B 激活的稀疏 MoE,Apache 2.0 许可,Hugging Face 提供 BF16、FP8、NVFP4 三档 checkpoint,官方报告有效上下文长度 100 万 token,定位为代码维护、工具调用与多步工作流的 agentic coding 模型。
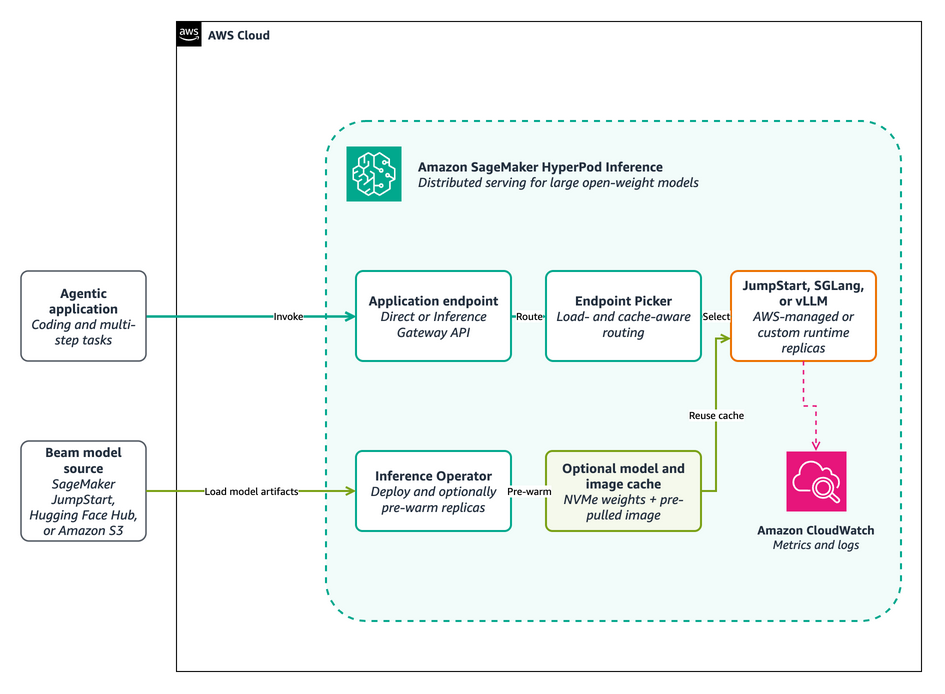
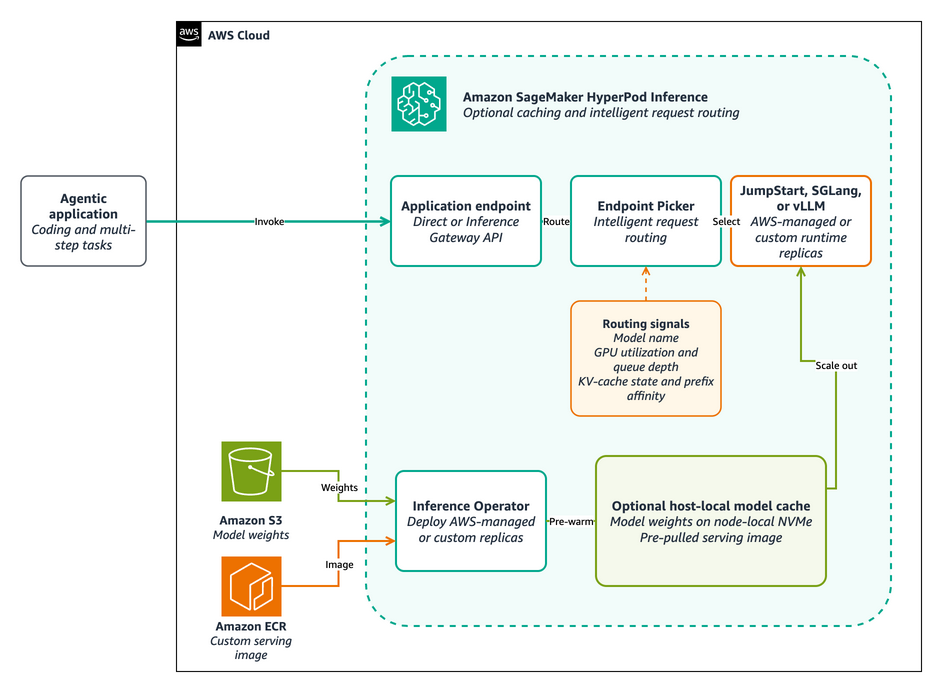
- 最新突破:AWS 官方博客给出 Beam 的完整托管路径——SageMaker JumpStart 实时端点(全托管,不操作 Kubernetes)、JumpStart on HyperPod Inference(AWS 托管容器与模型配置跑在 EKS 编排的集群上)、以及 SGLang 或 vLLM on HyperPod(自定义服务镜像、运行时参数、量化与分布式执行)。Beam 现已在 Amazon SageMaker JumpStart 的 US East (N. Virginia) 与 US East (Ohio) 两个区域可用。
- 硬件规格:FP8 走
ml.p5.48xlarge(NVIDIA H100)或ml.p5e/p5en.48xlarge(H200);NVFP4 走ml.p6-b200.48xlarge(B200);BF16 权重内存占用最大,需按多节点配置规划聚合显存。博客同时给出容量预留建议,可用 SageMaker training plan 做短期预留。 - 部署口径:501B 总参数决定 checkpoint 存储、权重内存、分片与并行布局;23B 激活参数决定每 token 计算量。容量规划需同时算上 KV cache、上下文长度、批大小与运行时开销,再按实测并发与延迟目标配置副本、缓存、路由与自动扩缩。
- 平台能力:HyperPod 侧提供模型与镜像缓存(预热节点本地 NVMe)、分层 KV 缓存与智能路由,Inference Gateway 给 OpenAI 兼容接口并在副本间分发请求;开发与实验可直接拉取 Hugging Face 的固定 revision,生产则建议把 checkpoint 复制到 S3 或 FSx。
- 行业意义:开源权重模型发布后的分发路径继续向云平台托管端点与 Kubernetes 原生推理栈延伸。对 500B 级 MoE 而言,能否部署的实际门槛由精度路径(BF16/FP8/NVFP4)与实例型号共同决定,而不只由权重许可决定——同一份权重在不同精度下的显存、机器数与单位成本差异,正在成为开源模型落地信息里的标准内容。 🔗 AWS Machine Learning Blog | JumpStart 部署示例 | HyperPod 部署示例 | Beam 1.0 权重