JetBrains 用 4,782 个会话校准编码 Agent 基准:SWE-Bench Pro 与真实任务流偏离
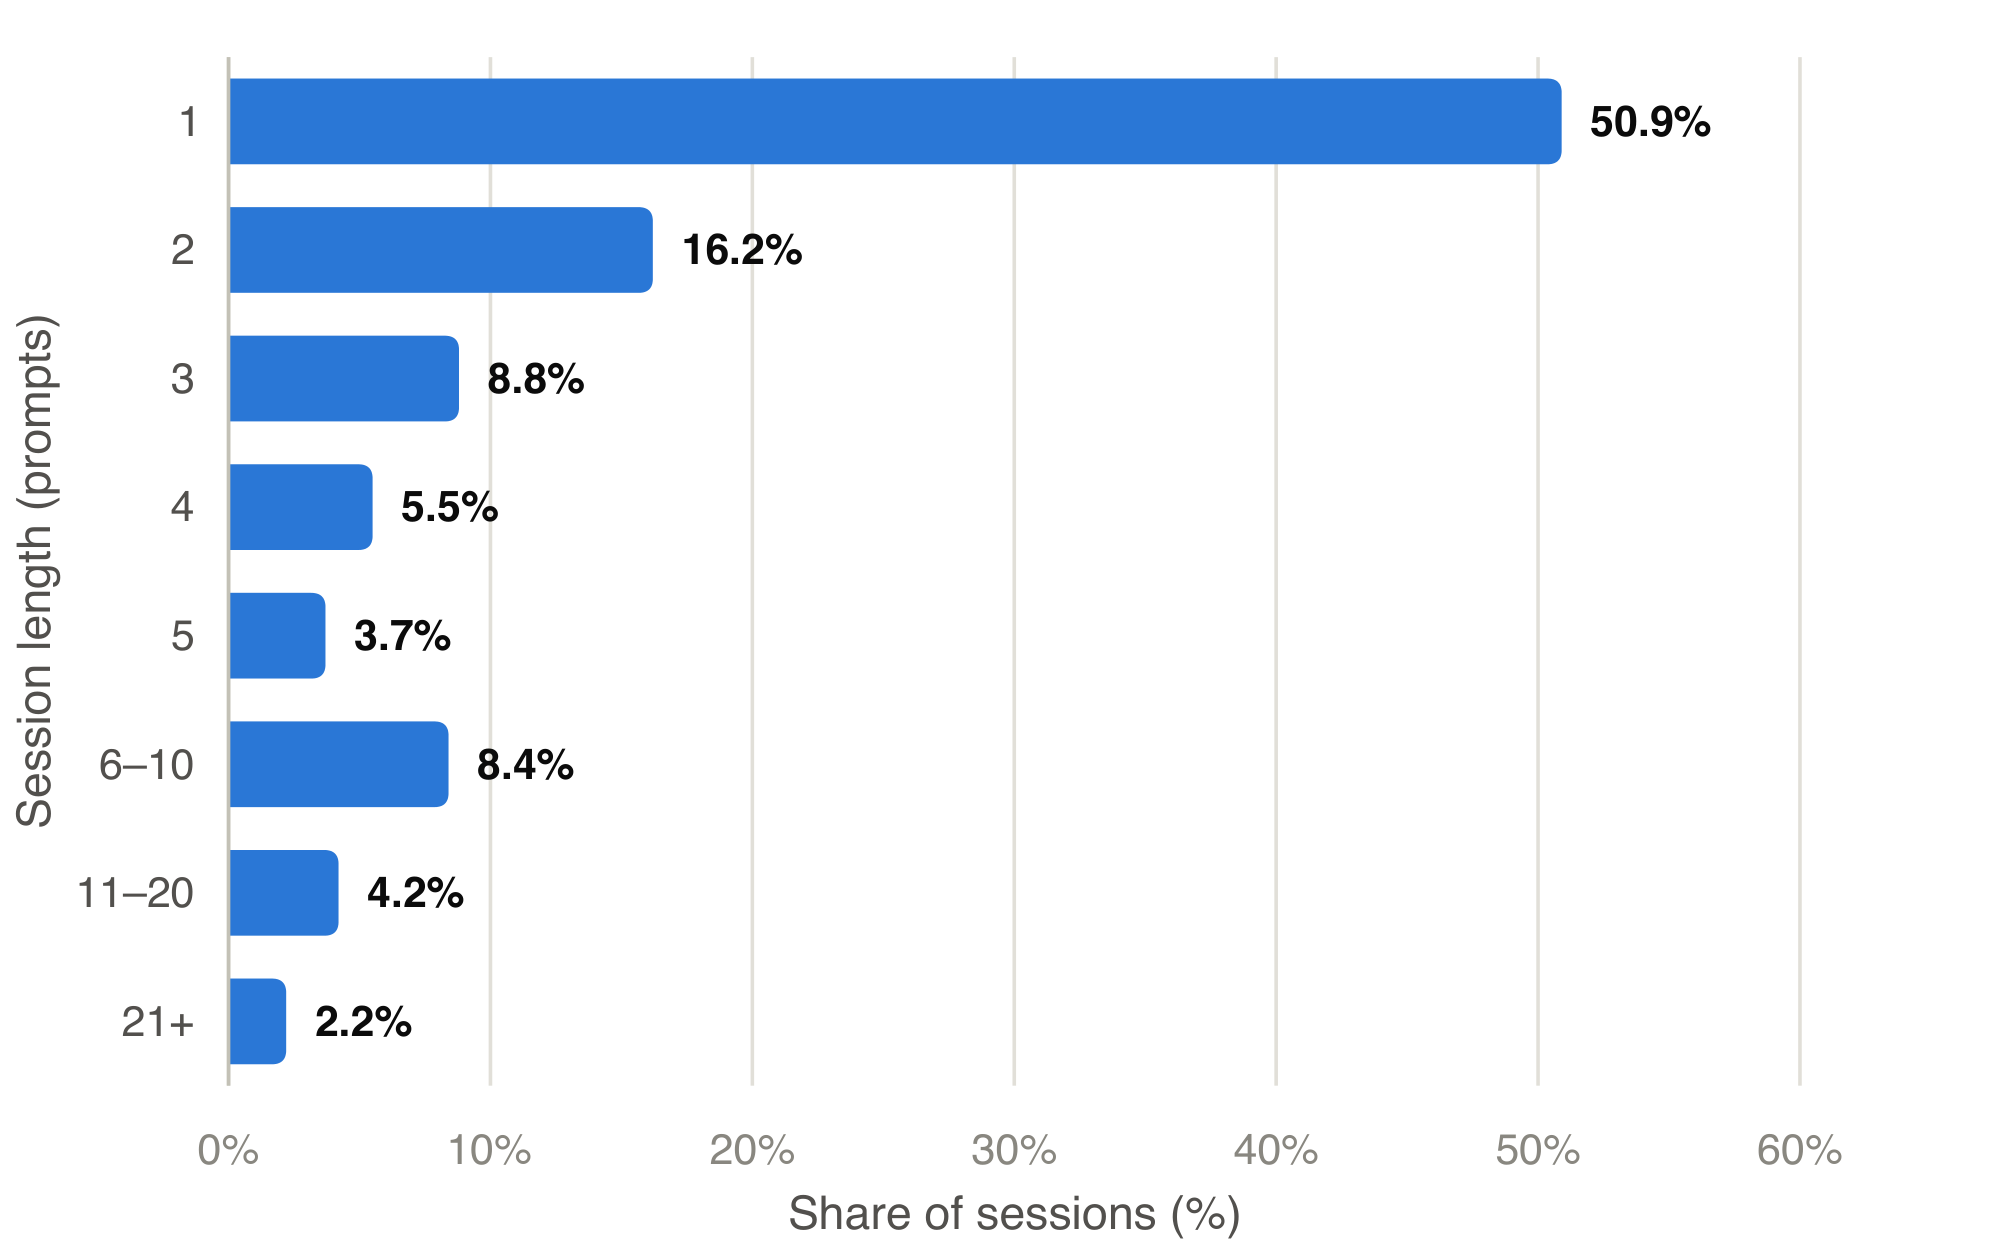
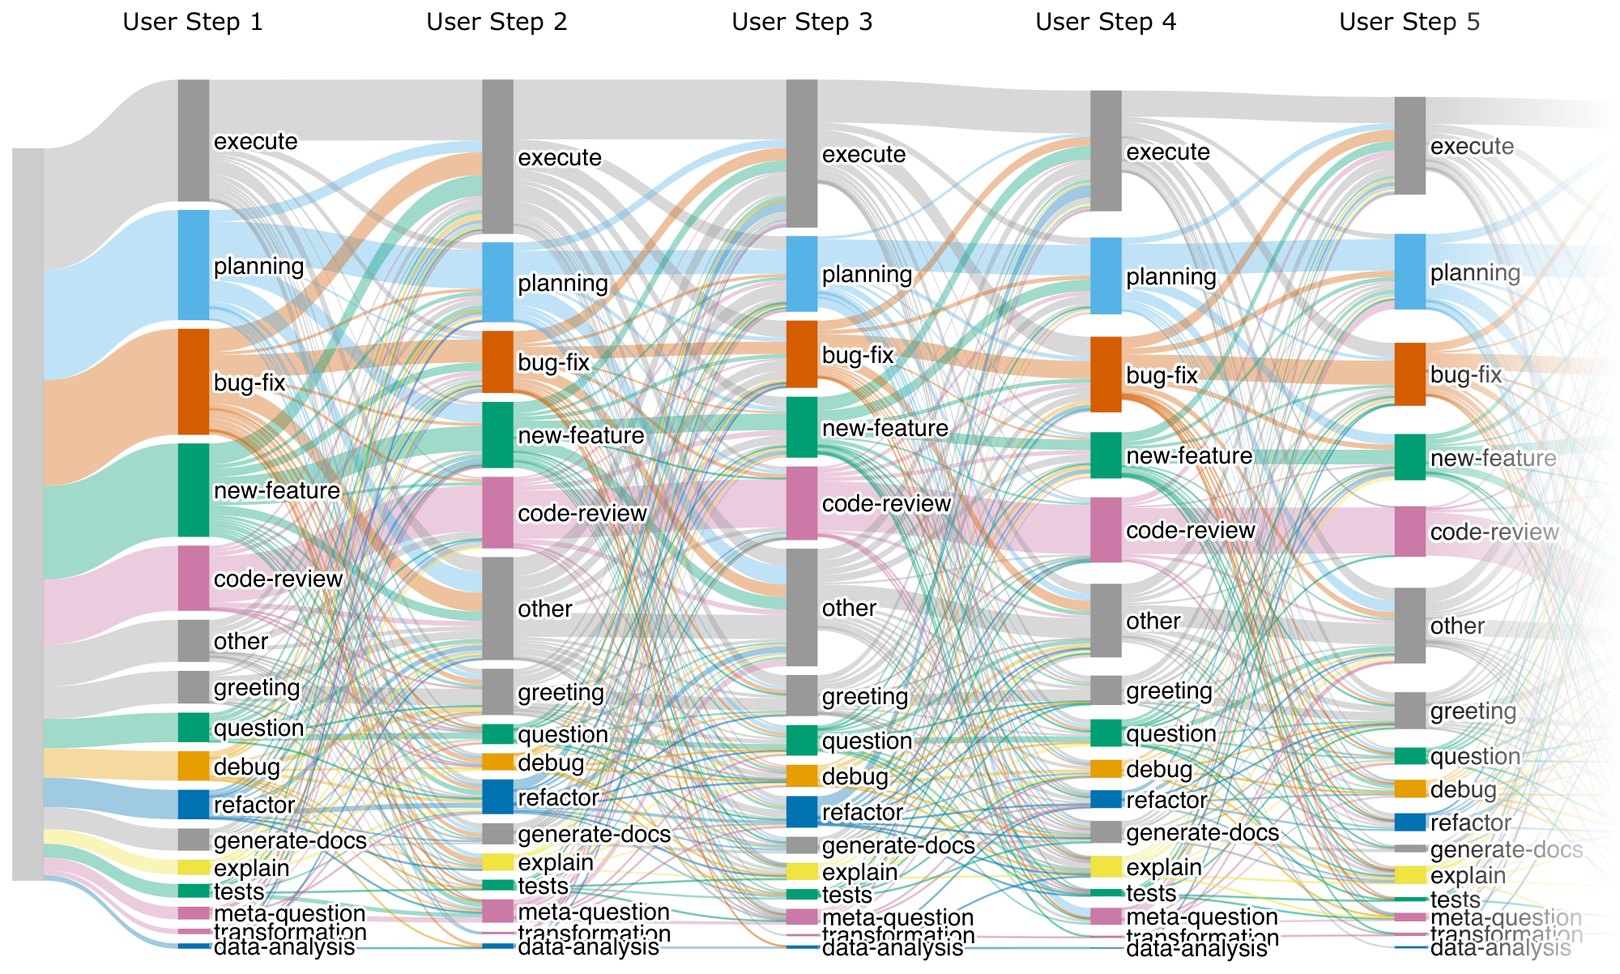
- 研究样本:JetBrains Research 统计 4,782 个 JetBrains IDE 内的开发者-Agent 会话,共约 14,000 条开发者消息;其中 50.9% 为单条消息会话,33% 为至少三条消息的长会话,后续分析集中在长会话。
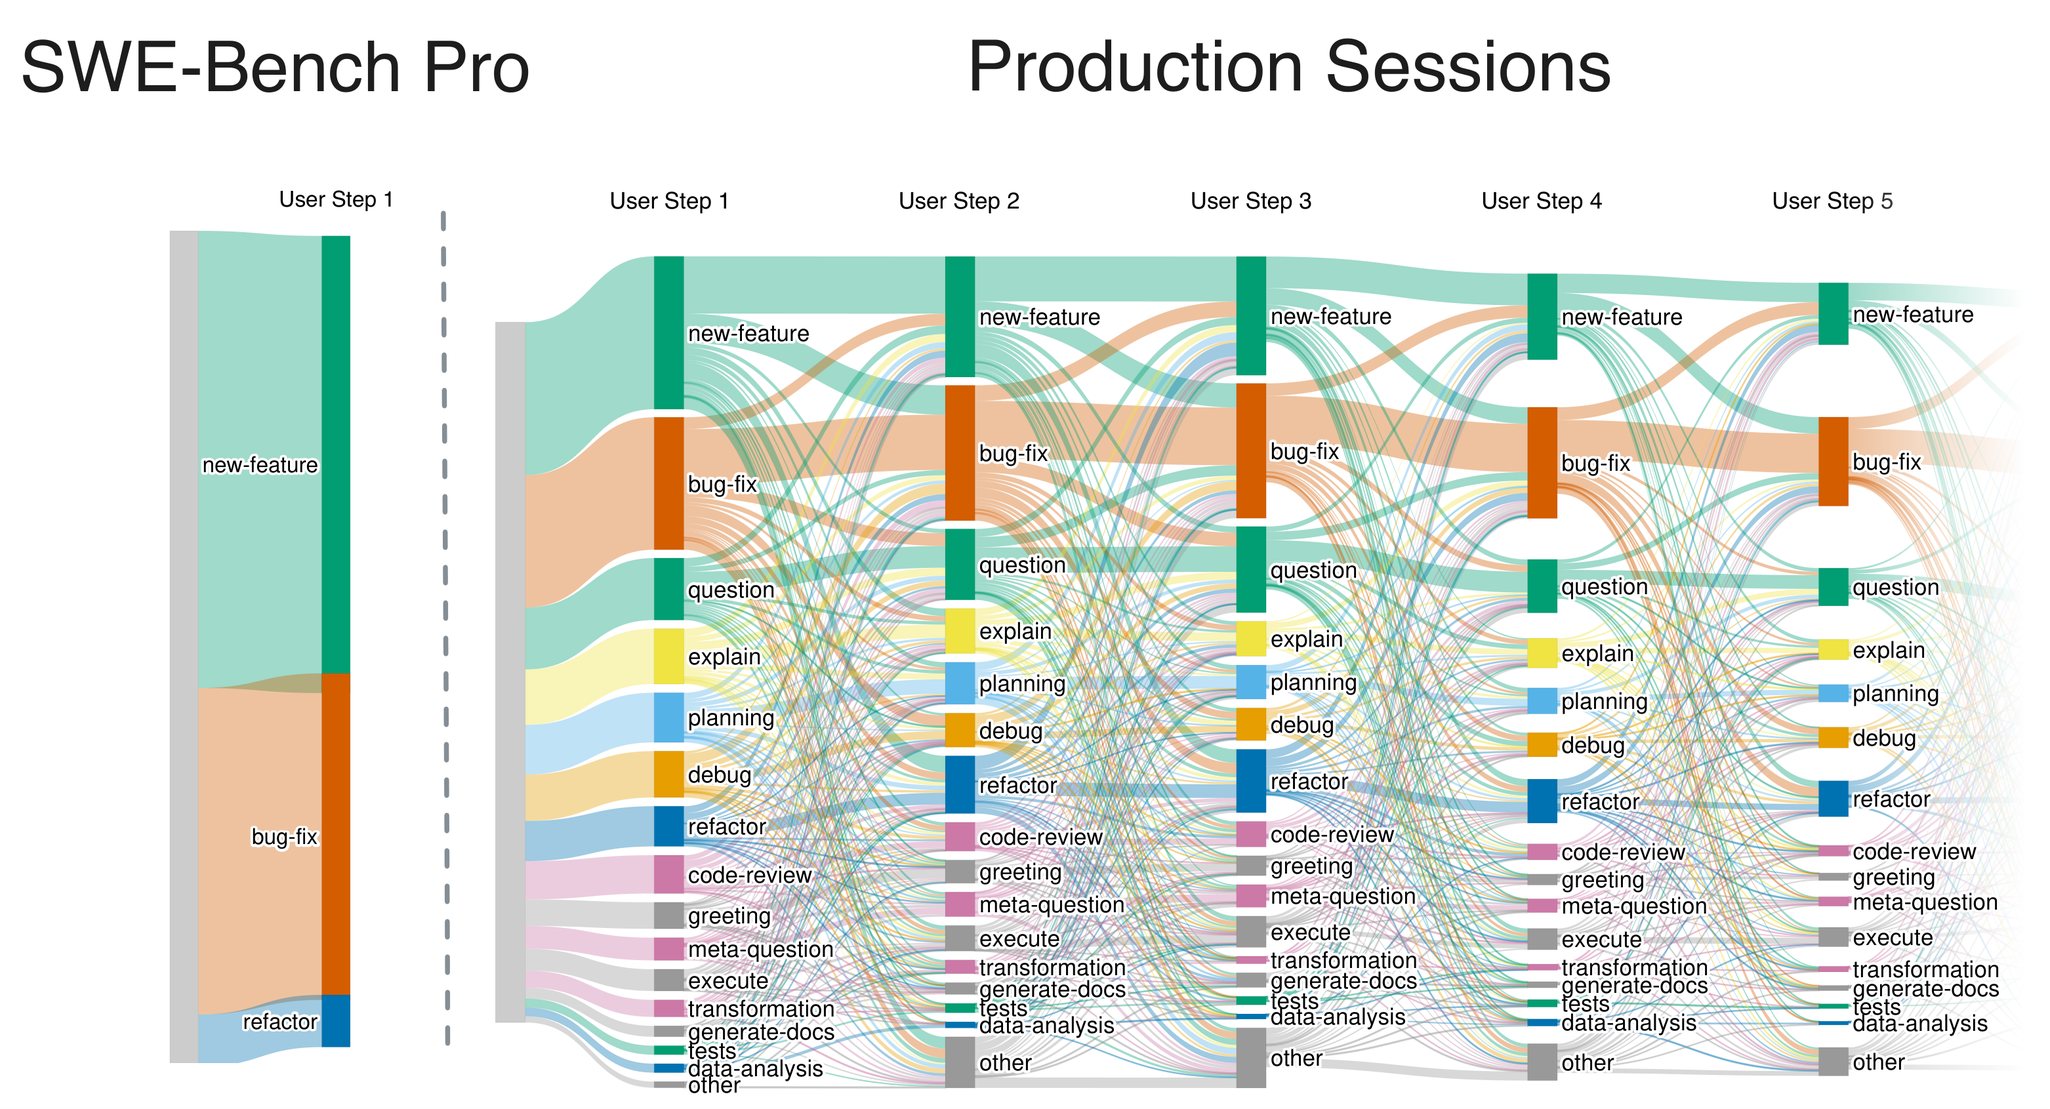
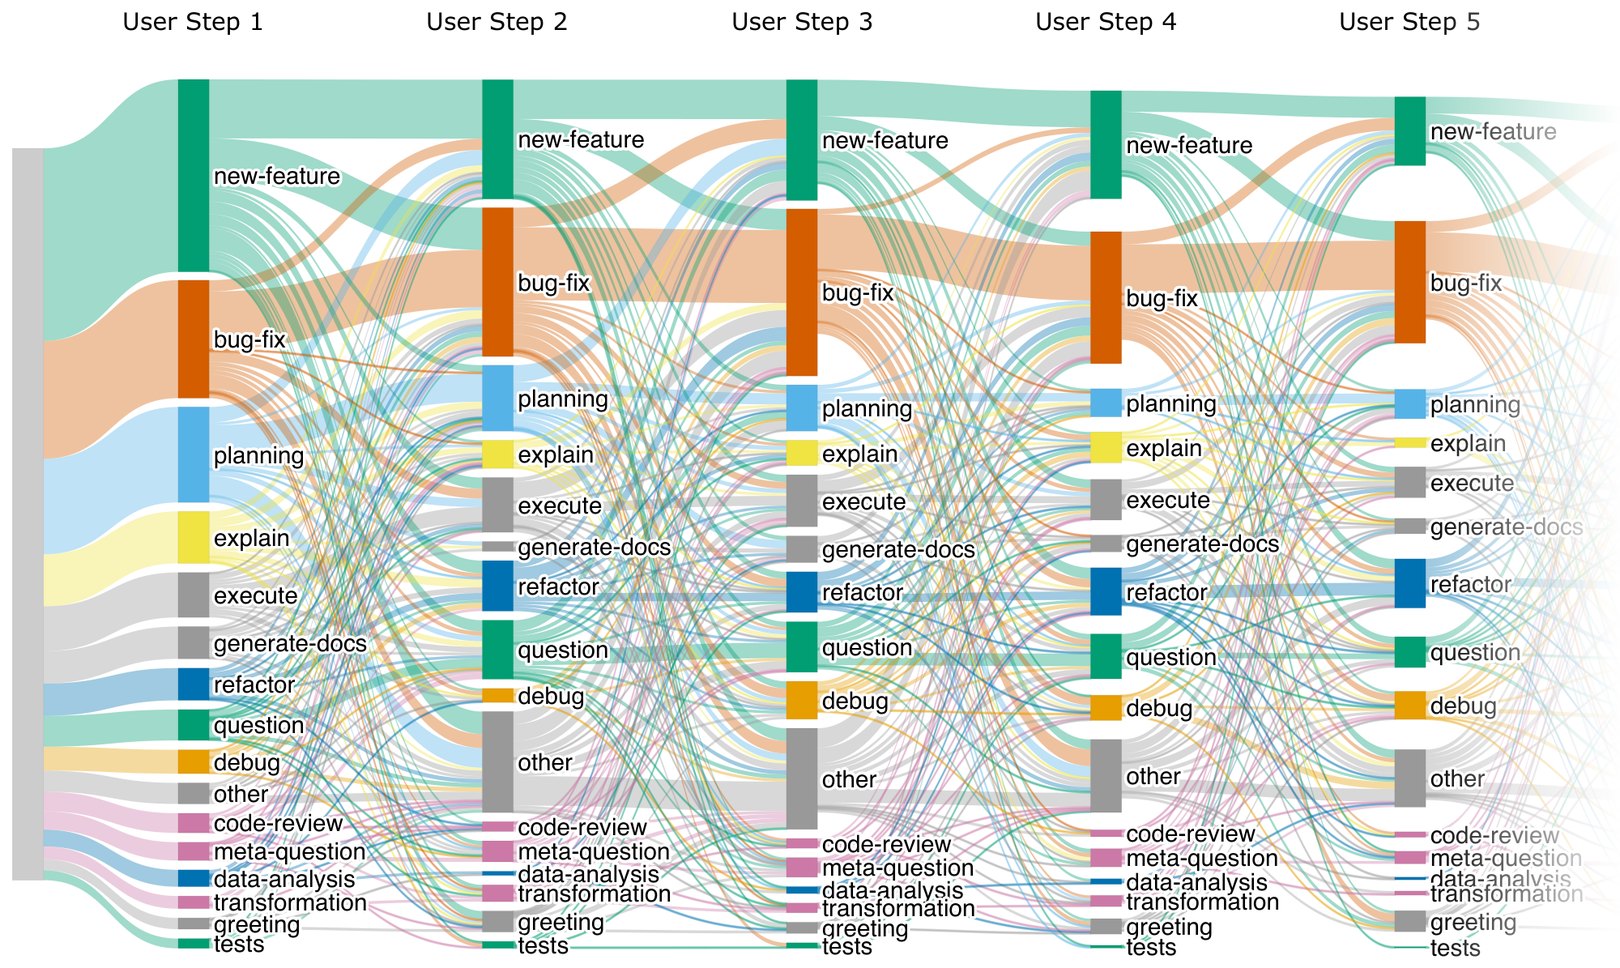
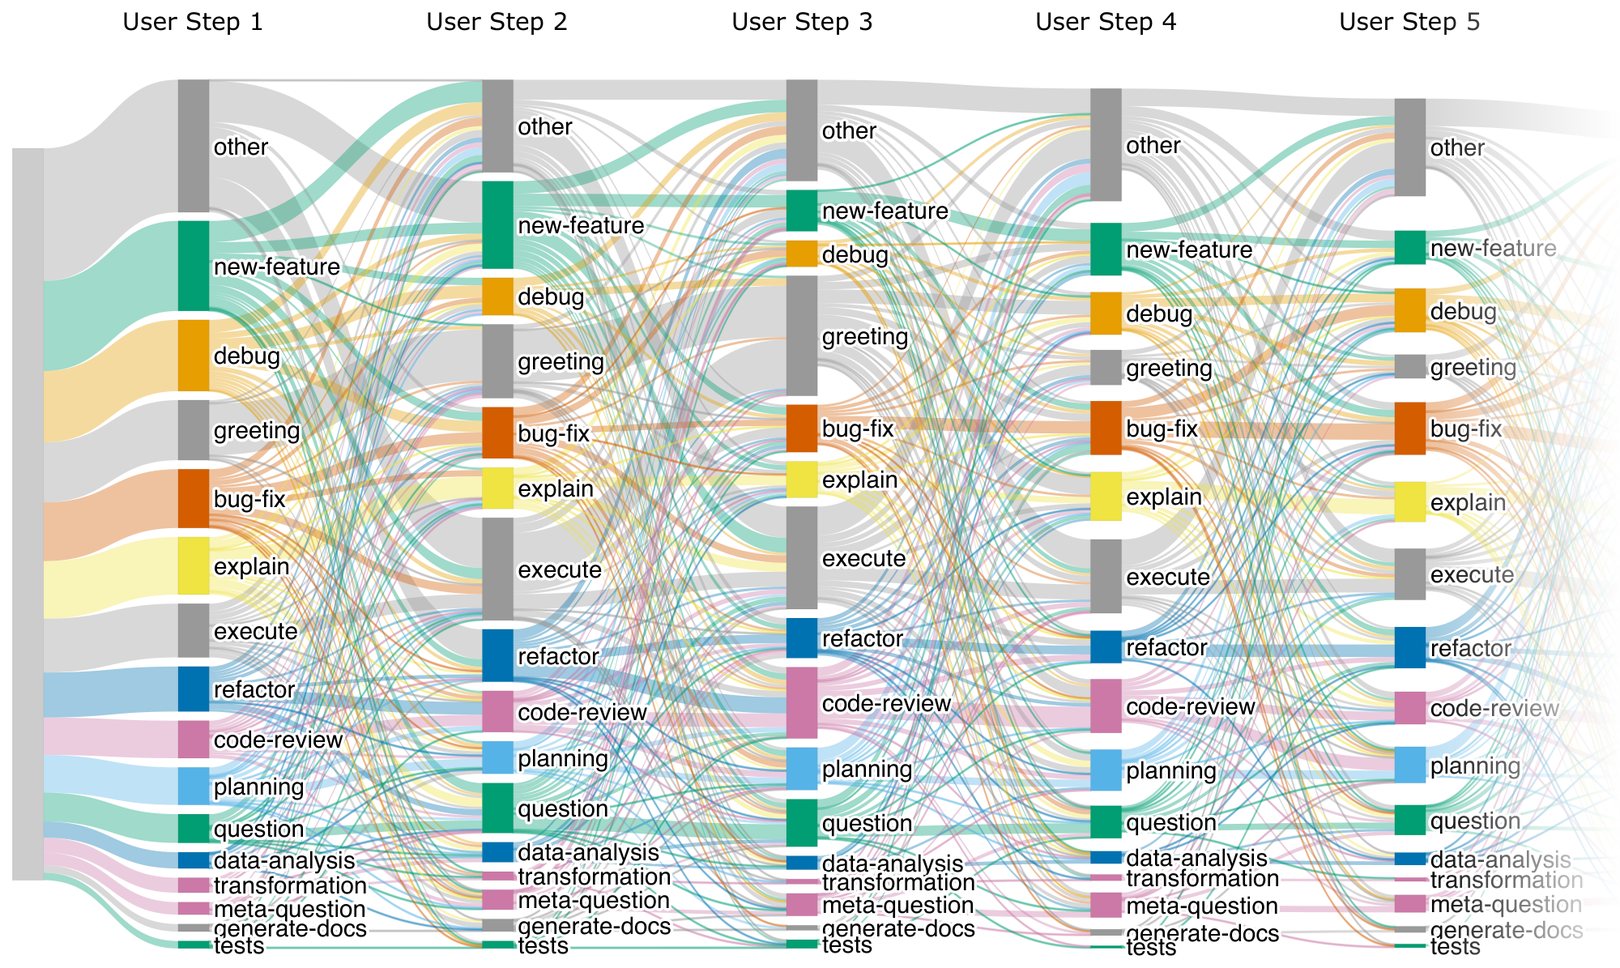
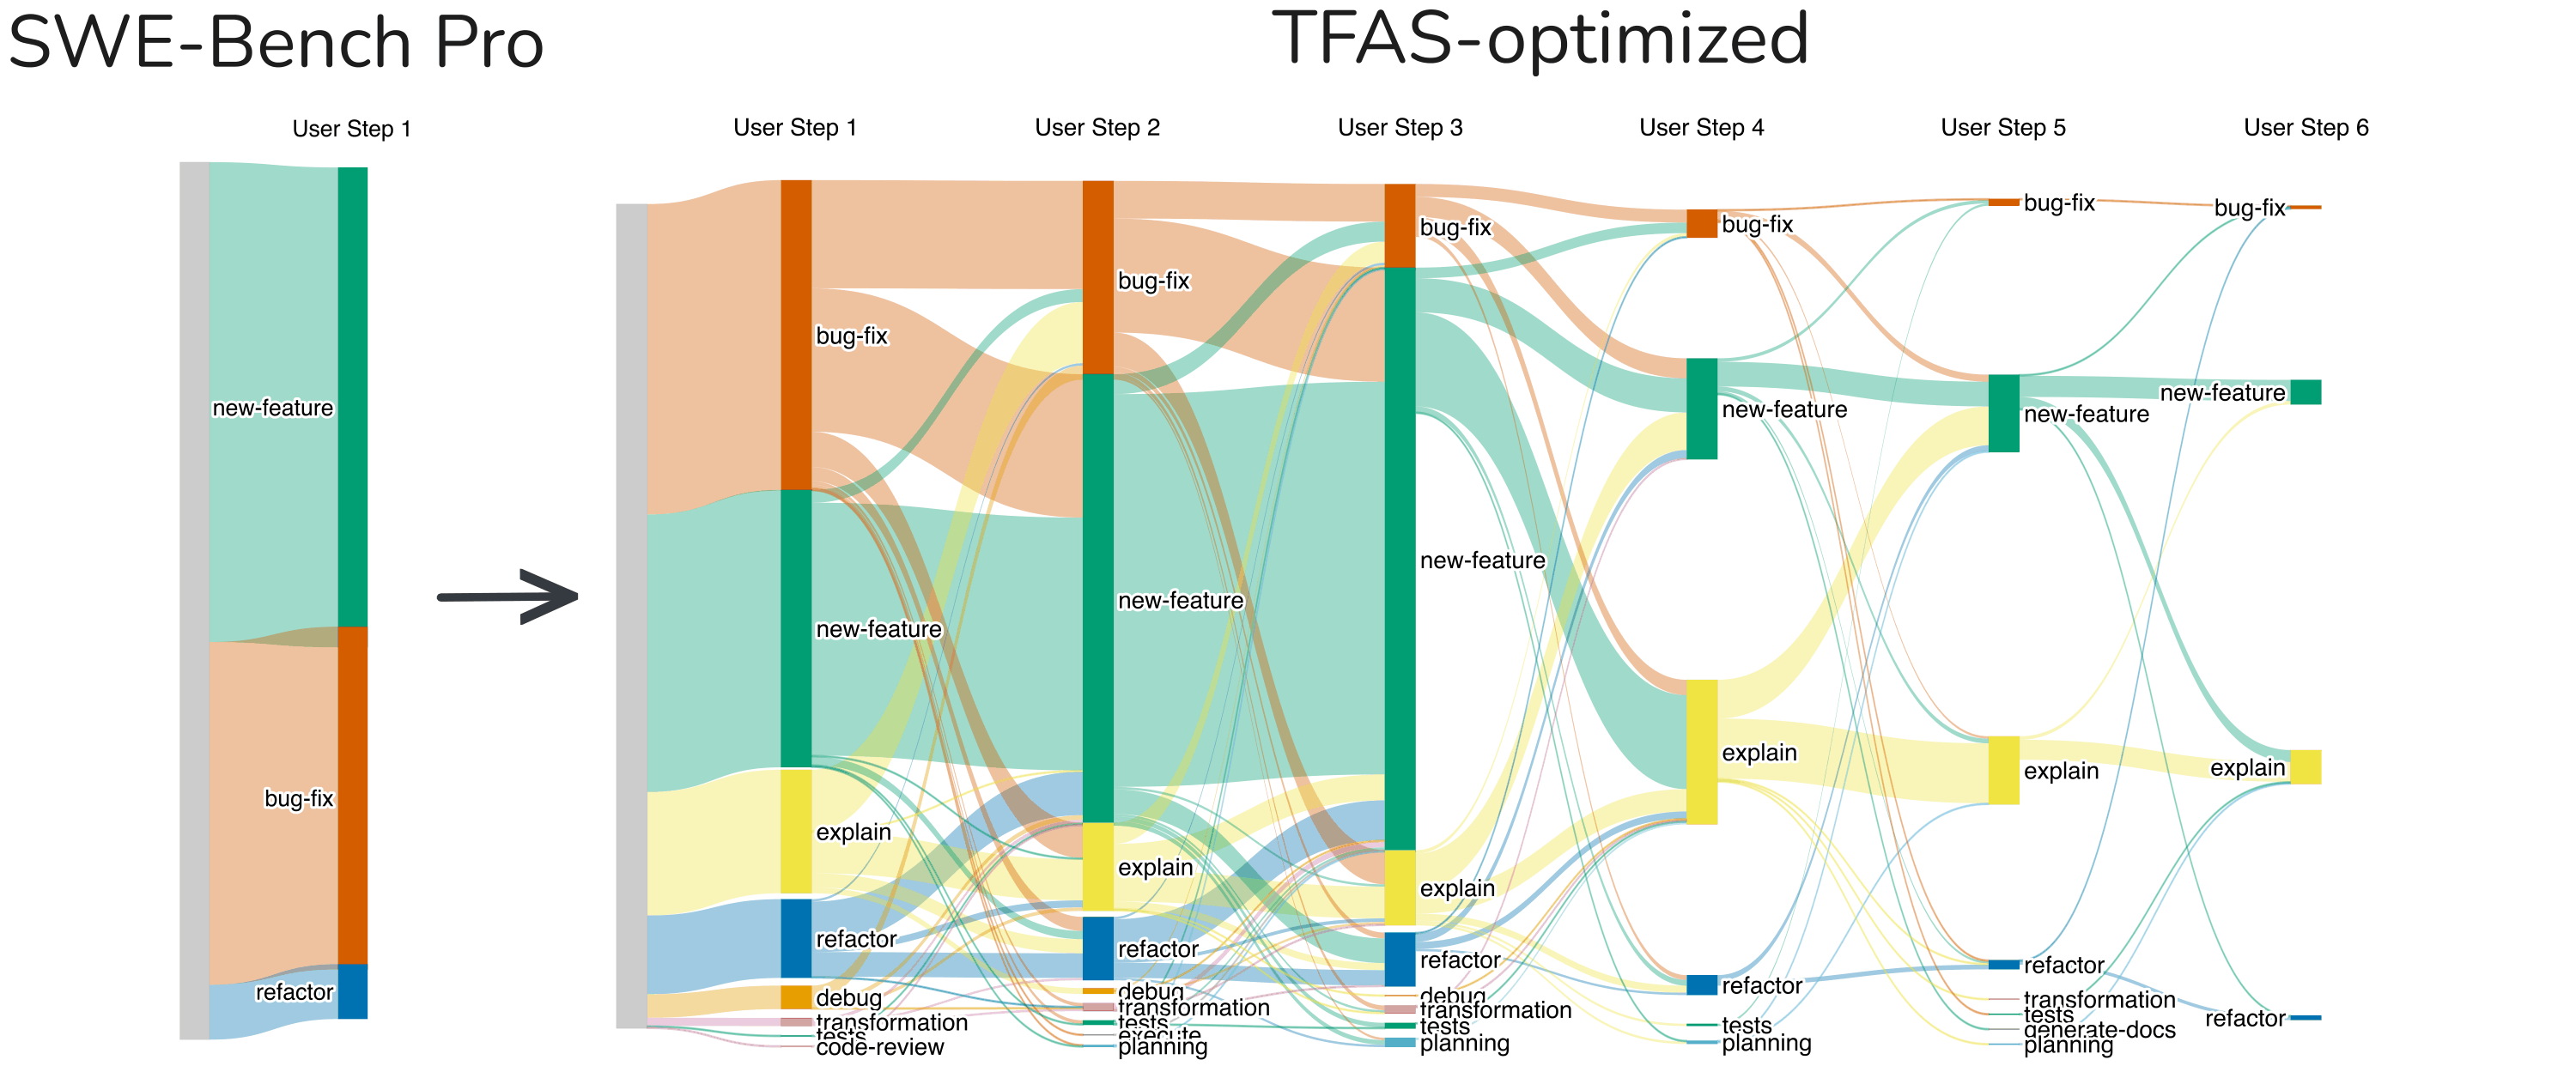
- 关键偏差:全部会话中修 Bug 占 26%、新功能占 19%;长会话里解释项目代码占 6%、通用编程问题占 10%,规划、代码审查、重构、调试与执行构成其余部分。SWE-Bench Pro 中 93.8% 任务是功能开发与修 Bug(55% 新功能、39% 修 Bug、6% 重构),且每个任务以一条完整消息给出。
- 基准改造:团队提出 SWE-TaskFlow,保留原基准的仓库、环境、测试与需求,只重新生成用户消息:把 issue 拆成三条有序请求,并插入 1–3 个可从仓库验证的问答;最终得到 700 个任务、255 个任务带 454 个问答。TaskFlow Alignment Score 从纯拆分的 59.6 提升到优化后的 77.8。
- 试点结果:在 GPT-5.6 Luna、GPT-5.6 Terra、GPT-5.4 Mini 与 Gemini 3.7 Flash 上,把需求拆成三条消息使每个模型的单任务成本变为 2.0–2.6 倍;解决率变化较小,Terra 持平,其余三款平均下降 4–5 个百分点,与单次运行波动相当。加入仓库问答再增加 4%–24% 成本,问答准确率 69.8%–83.0%。
- 行业意义:这组数据把编码 Agent 评测从“单条完整 issue 的解决率”拆成任务流对齐、渐进式需求披露与理解成本三个可分别计量的部分。对选型而言,同一模型在单轮基准与多轮交付下的成本、成功率可能不同;基准需要声明所校准的用户群体,稀有但高风险的行为则宜单独做压力测试。
- 限制:当前只生成 issue 请求与仓库问答,规划、审查、执行等其他真实意图仍需各自的任务生成器与验证器;所有消息在运行前固定,无法测试 Agent 对用户反馈的响应。 🔗 JetBrains 博客 | 论文 | 数据集