AWS 发布 SageMaker MTRL 实操指南:gpt-oss-20b Wordle 解决率从 61% 提至 84%
- 前情提要:AWS 此前宣布 SageMaker AI training sessions 正式可用,支持 SFT、DPO、RLVR、RLAIF 与多轮 RL,按 token 计量,平台托管 GPU。
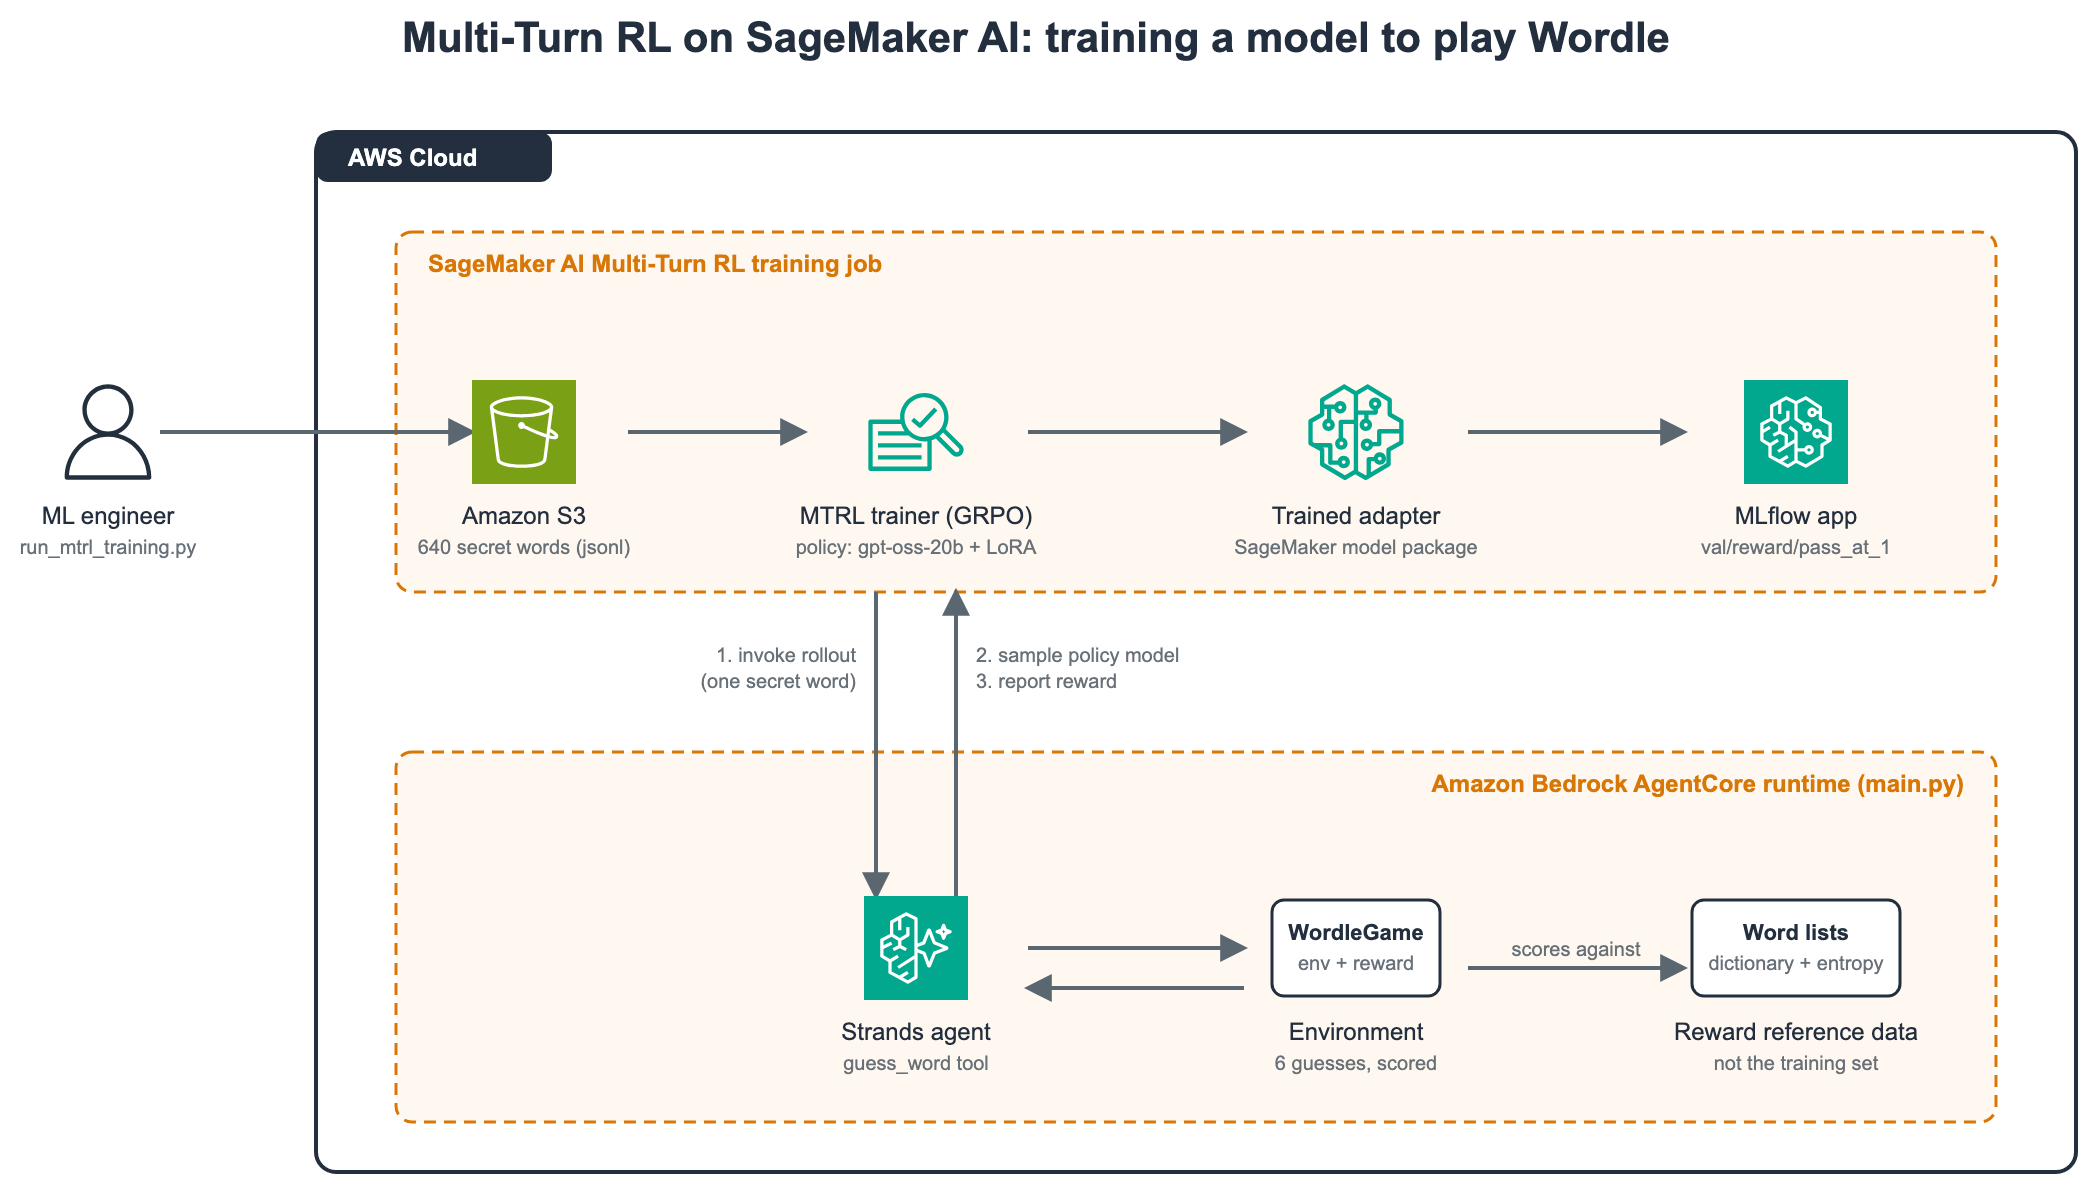
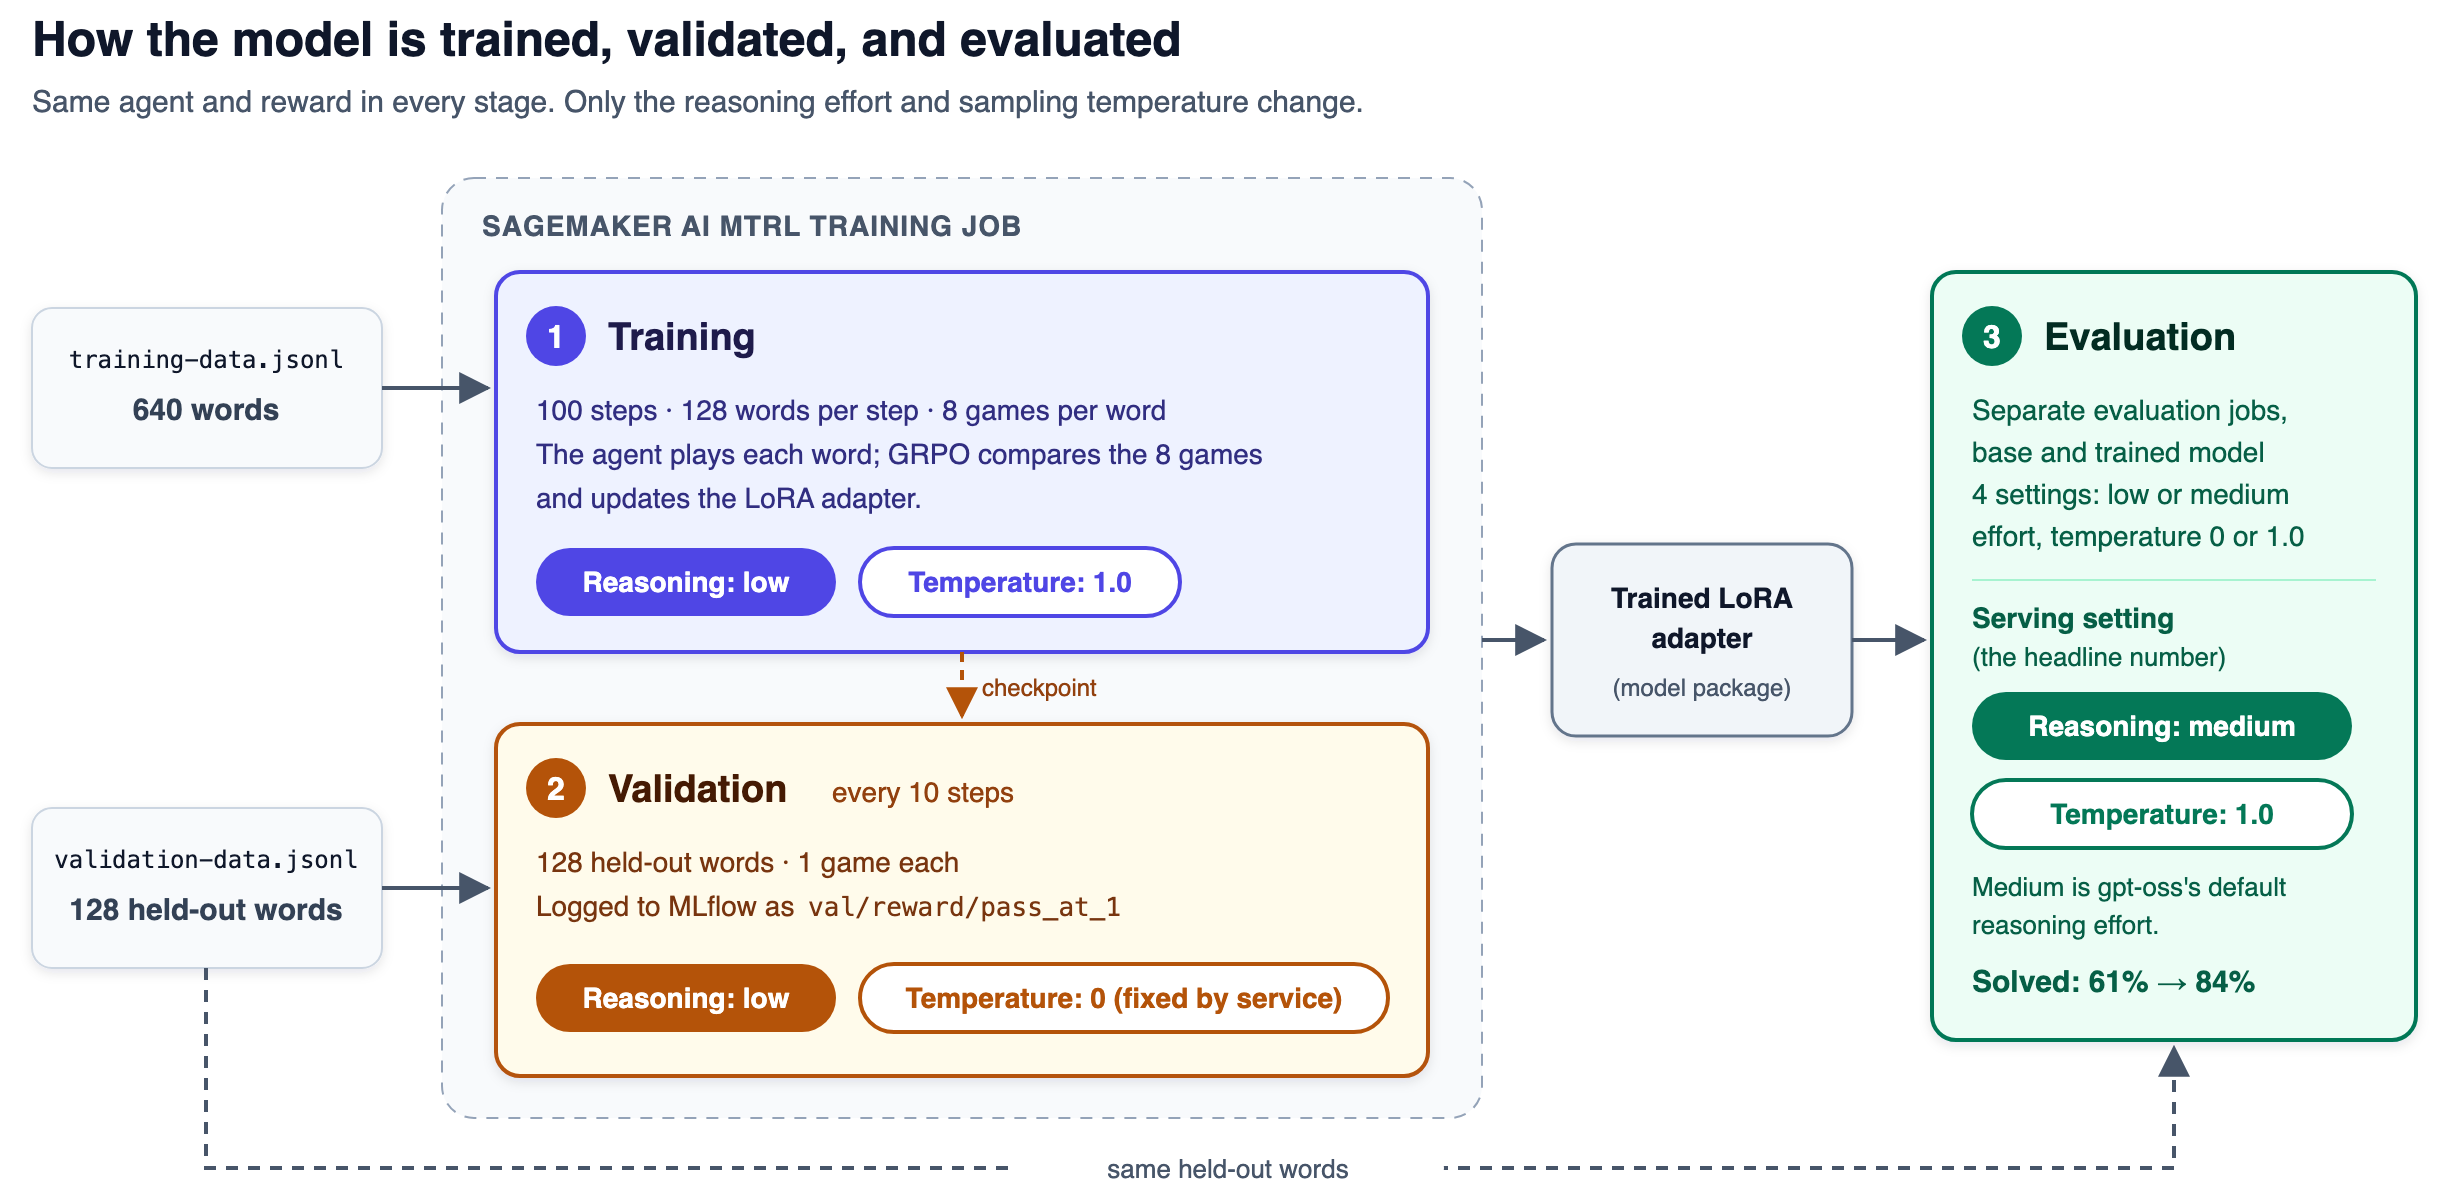
- 最新进展:AWS Machine Learning Blog 发布 MTRL(Multi-Turn Reinforcement Learning)完整实操指南,以 Wordle 为例,将训练作业与策略模型放在 SageMaker AI,agent、环境与奖励函数托管在 Amazon Bedrock AgentCore,通过 AWS Lambda forwarder 连接;GRPO 根据同一词多次 rollout 的奖励分布更新 LoRA adapter。数据集只携带谜底,"正确轨迹"由 agent 自行探索。
- 实测数据:100 步训练消耗约 4.92 亿 prefill、1.60 亿 sample、6.43 亿 train token,约 105,486 次 rollout,12 小时 40 分钟;按 GPT-OSS-20B 美东列表价,训练 token 成本约 338.50 美元,AgentCore runtime 约 79 美元(基于 CloudWatch 用量与美东列表价)。gpt-oss-20b 在默认推理强度下留出词解决率从 61% 提升至 84%,在训练所用低推理强度下从 15% 提升至 69%。
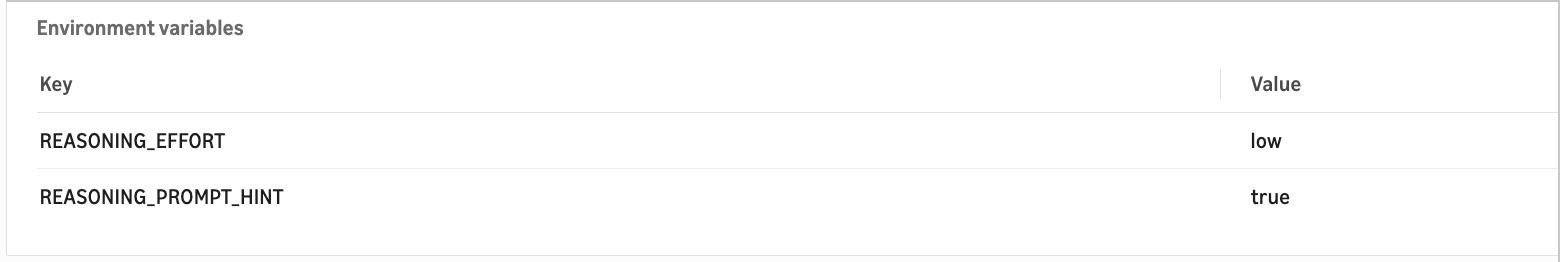
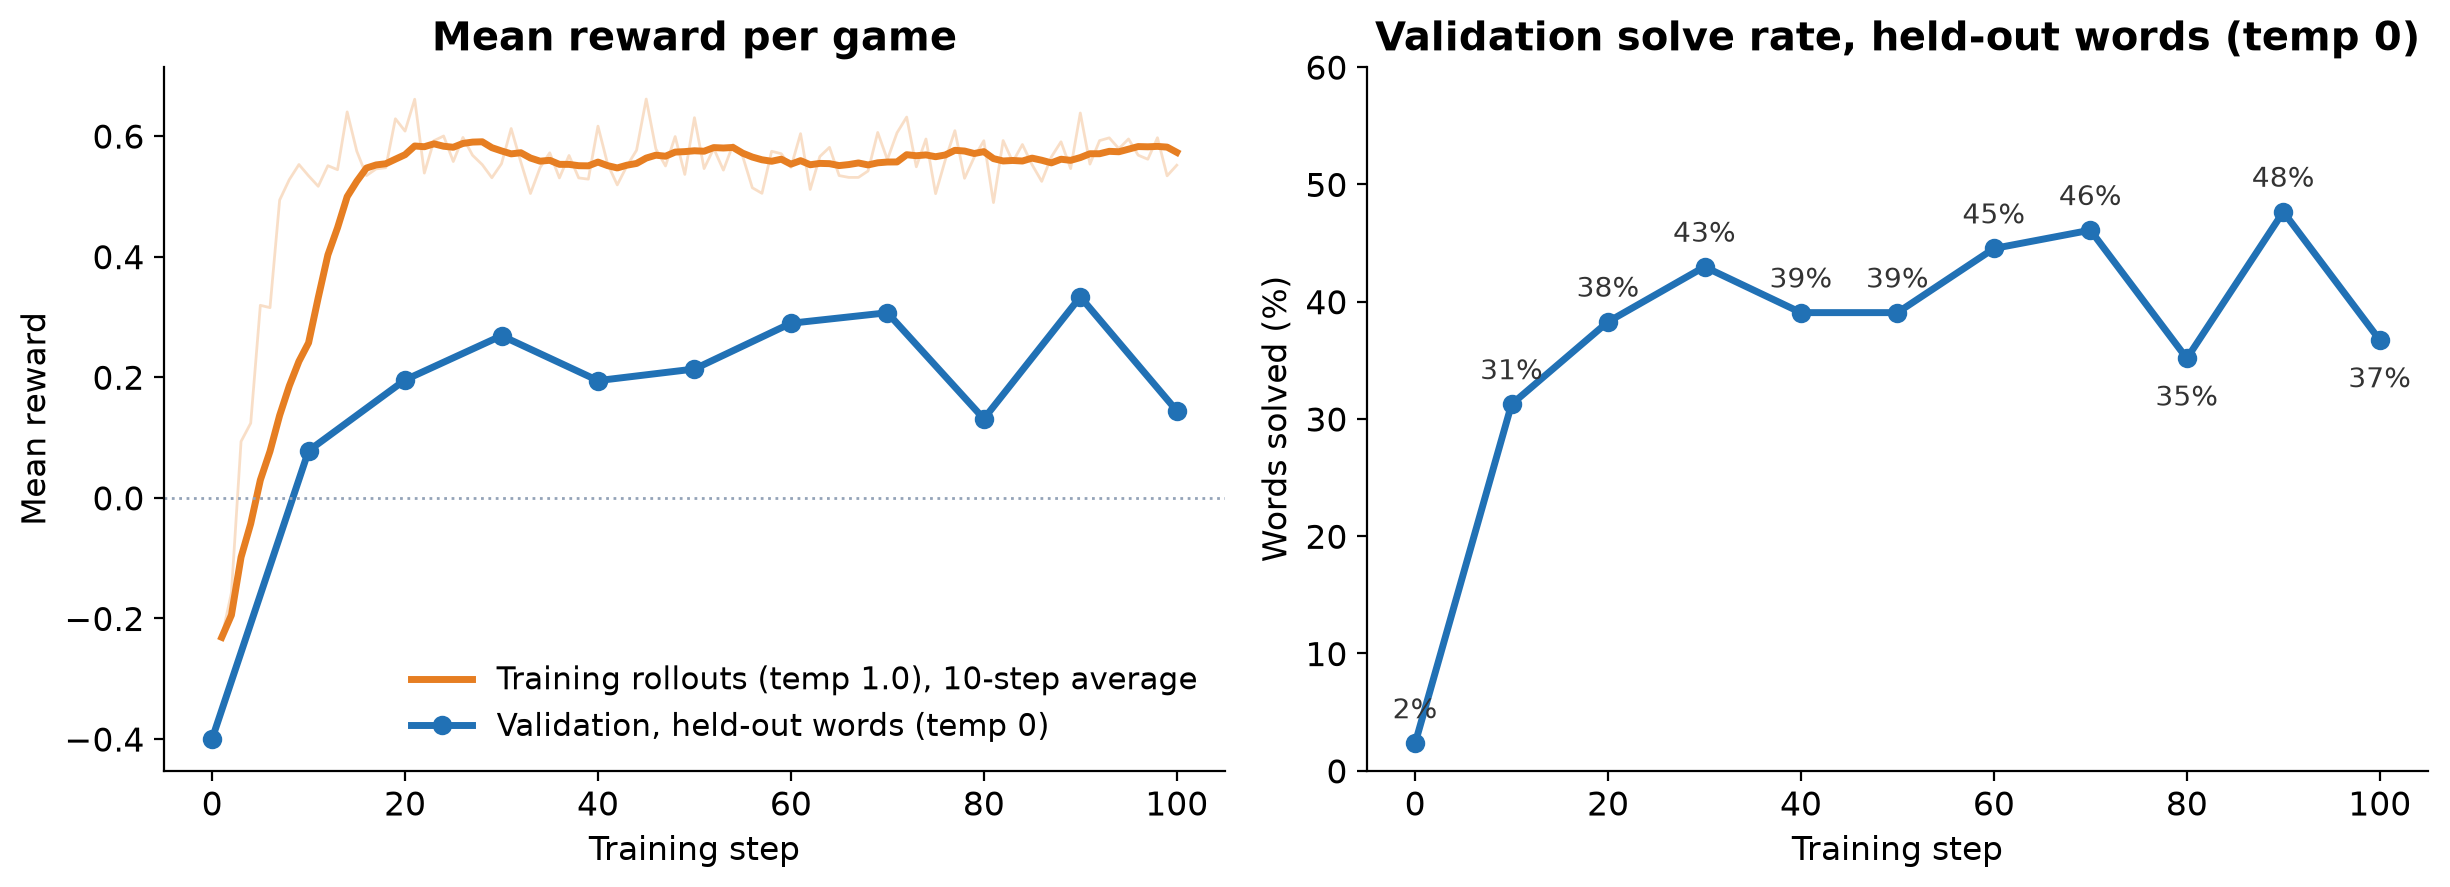
- 评估口径:训练曲线在温度 0 下报告解决率峰值 48%、终值 37%,但按实际 serving 设置(中等推理强度、温度 1.0)评测为 84%;AWS 明确要求"按 serving 设置评估",并指出训练验证在温度 0 下低估了模型。
- 奖励设计教训:第一版将逐次猜词得分累加为游戏奖励,导致输掉的比赛奖励为正(+0.49)、第 1 次猜中得分低于第 3 次猜中(+0.99 vs +1.61);修复为 outcome 主导项(1.05–1.55 按猜中次数递减)+ 加权截断 shaping 项(solve 0.04、loss 0.15),保证每次解决都优于每次失败,且更快猜中优于更慢猜中。
- 四个失败模式:并发下 bearer token 饥饿(需单一自刷新会话 + 短缓存 + 403 时重签);rollout 未触达策略模型导致整个作业失败(应始终返回奖励,最低 -1.5,100 步运行中约 105,000 次 rollout 中有 51 次此类);学习率过高使工具调用漂移为纯文本、梯度消失(agent 现从原始文本恢复猜词并加格式惩罚);约 step 15 后奖励停滞(可尝试课程学习或提高 group_size)。文中还给出 IAM 信任主体应为
job.sagemaker.amazonaws.com而非sagemaker.amazonaws.com的具体排查提示。 - 支持范围与计价:当前支持 Amazon Nova 2 Lite、GPT-OSS-20B、Gemma 4 31B(instruction-tuned)、Qwen 3.6 27B,均通过 LoRA adapter 训练;计费按 prefill / sample / train 三个 token 维度分模型定价,train 维度随轨迹长度增长,是主要成本项。
- 行业意义:MTRL 让模型在"整个 episode 的结果"上训练,适用于正确轨迹不可知、只有结果可评分的 agentic 任务。AWS 把训练流水线、AgentCore 托管环境、GRPO + LoRA、MLflow 监控与 serving 评估串成可复现流程,并公开示例仓库与失败记录;对希望用小模型在垂直多步任务上替代通用模型的团队,这是一条可复制的工程路径。同时,"训练曲线 37% vs serving 84%" 的差异提醒:报告数字必须与实际部署条件对齐,否则同一模型的能力会被系统性低估。
🔗 AWS Machine Learning Blog | GitHub 示例仓库 | MTRL 文档