DeepSeek V4.1-Flash-1017 第三方对比:专项任务领先,综合推理仍落后 Opus 5
- 前情提要:DeepSeek 官方昨日发布 V4.1-Flash-1017,称其在基准表现、任务完成速度与输出长度上实现帕累托改进,同步上线官网、App 与 API,并开放自研 Search 与 Fetch 接口,权重已在 Hugging Face 与 ModelScope 开源;此后该模型进入 OpenRouter,Artificial Analysis 披露其架构为 552B 总参数、16B 激活,AA 智能指数 39,在 LMArena Agent Arena 开源榜排名第二。
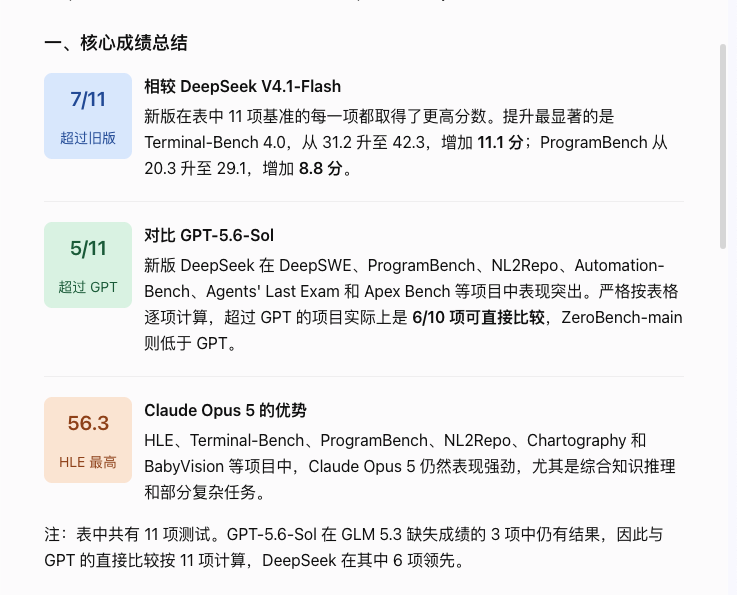
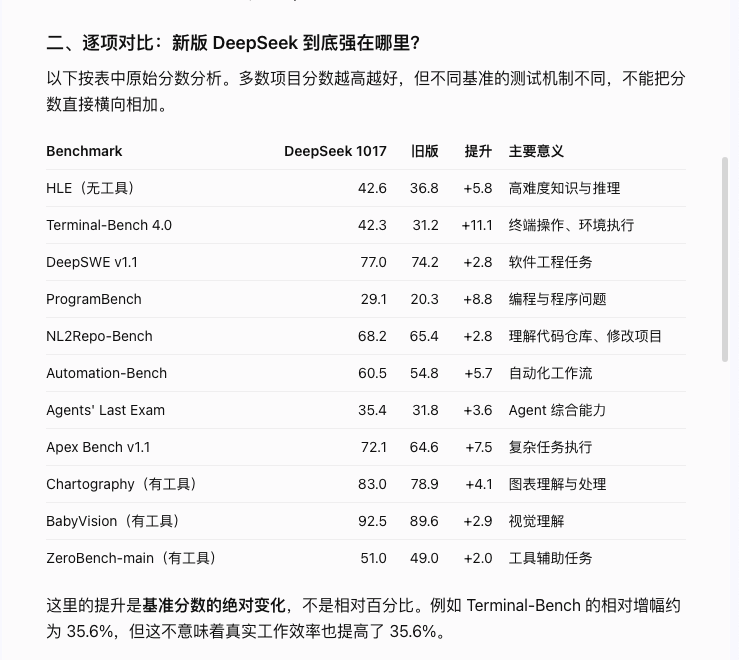
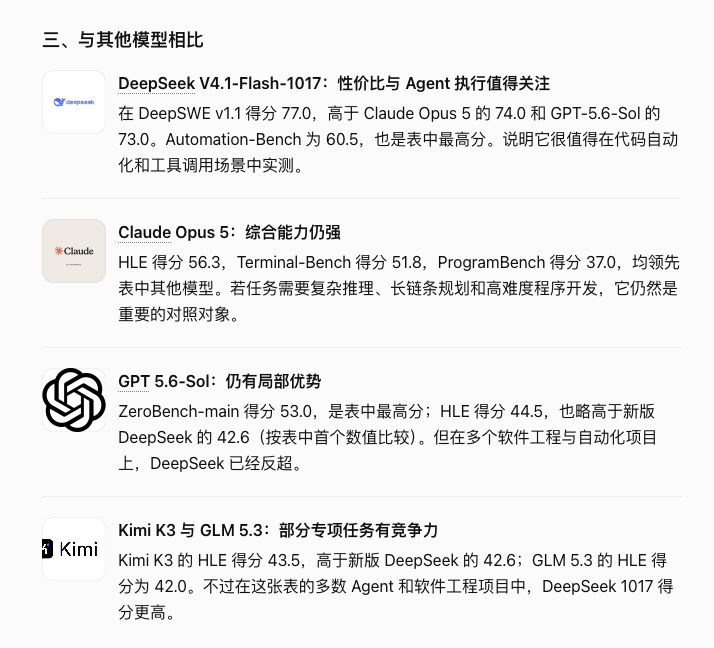
- 最新对比:Geek 转述的基准截图显示,V4.1-Flash-1017 在编程、终端操作、Agent 执行与复杂任务等专项基准上超过 GPT-5.6-Sol;但在综合推理和部分高难度编程任务上,Claude Opus 5 仍保持领先。
- 信息边界:该对比来自单个 KOL 对官方 API 文档与截图的转述,未披露完整评测集、评分口径、运行配置与第三方复现结果;DeepSeek 官方发布信息中并未点名 GPT-5.6-Sol 或 Opus 5 作为对比基线。
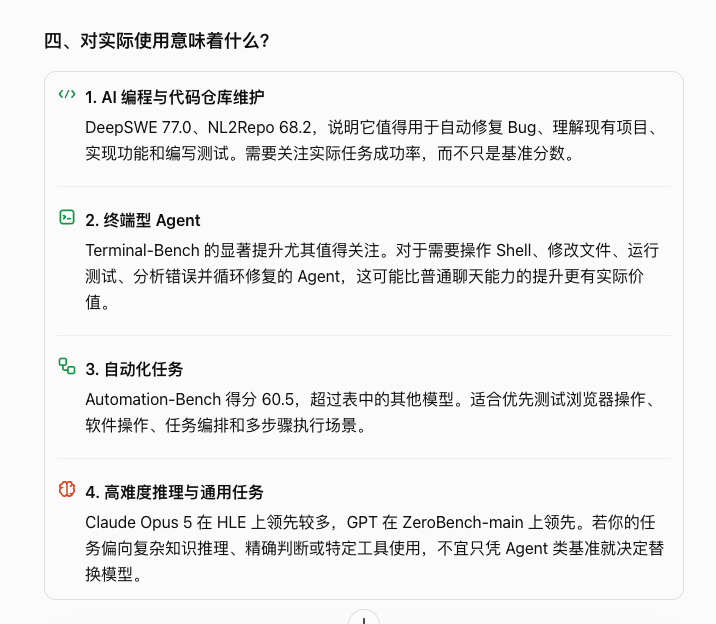
- 行业观察:专项 Agent 任务与综合推理之间的能力分布并不重合。对需要在编程 Agent、终端操作与复杂任务之间做模型选型的团队而言,单点基准的领先不等于端到端工作流的优势——任务拆解、错误恢复与上下文管理仍会改变实际表现。