AWS 发布 Trainium 训练 Qwen3 教程:torchtitan 三种配置共用同一启动方式
- 核心发布:AWS Machine Learning Blog 发布教程,在单台
trn2.48xlarge(16 颗 Trainium2,LNC=2 下 64 个逻辑 NeuronCore)上,用 torchtitan 训练 Qwen3。TorchNeuron 将 Trainium 注册为原生 PyTorch device,torchtitan 启动时自动识别;三种配置均使用相同的torchrun启动模式与配置结构。 - 三条路径:第一种以 Transformers v5 作为建模后端,通过
AutoModelForCausalLM加载 Hub 模型并直接读写 safetensors;第二种通过config.model_spec切换到 torchtitan 原生 Qwen3 实现;第三种在 torchtitan-neuron 配方中加入 NKI MoE 内核,并用 override registry 附加自定义 NKI kernel。 - 可核对数据:教程用
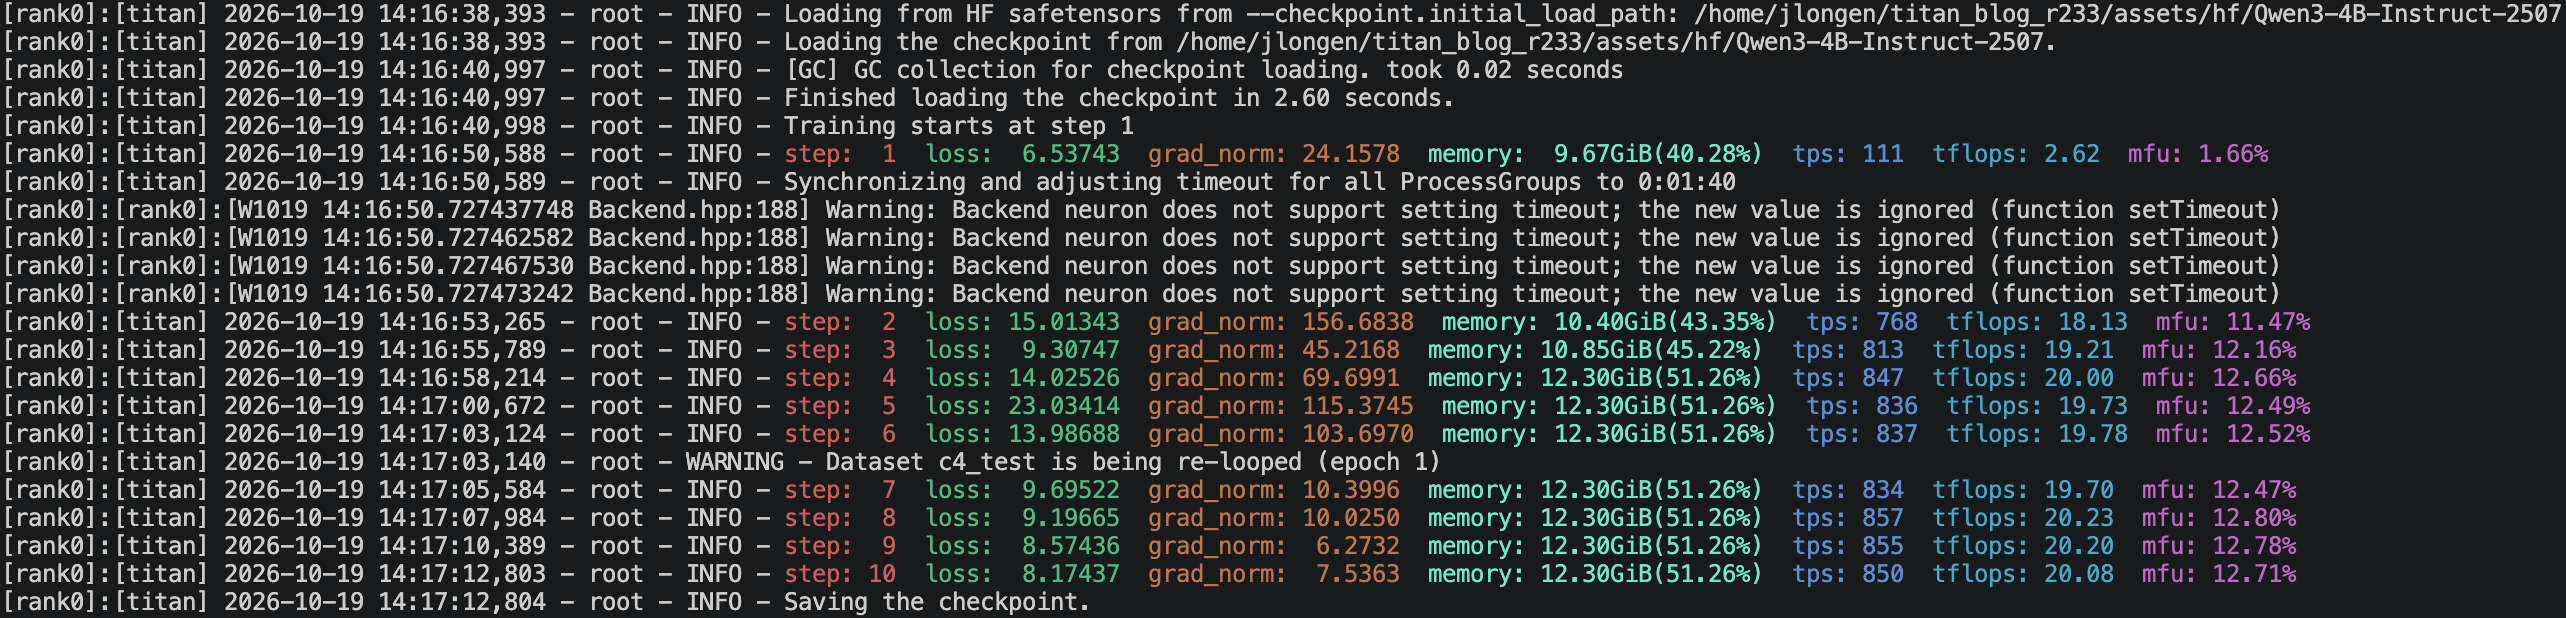
Qwen/Qwen3-4B-Instruct-2507做微调校验,从公开权重加载时第 1 步 loss 为 6.54,随机初始化为 12.43;导出 checkpoint 可被AutoModelForCausalLM重新加载,除 tied embedding 的lm_head.weight外无缺失或意外键。 - 工程约束:示例固定 torch 2.14.0、torch_neuronx 2.14.3、transformers 5.16.0 与 torchtitan-neuron release-2.33;自定义 NKI RoPE 需满足序列长度为
128×LNC的倍数,并先与 PyTorch 实现做数值对比——float32 下最大绝对误差为 0.0。 - 行业意义:torchtitan 是 PyTorch 原生的大模型训练框架,此次教程把 Trainium 纳入其配置与启动范式:Qwen3 可从 Hugging Face 权重微调,也可用原生模型实现或替换 MoE/自定义内核。对开发者而言,非 NVIDIA 加速器上的训练入口更接近标准 PyTorch 工作流;代价是版本固定、LNC 对齐与内核级调优仍需逐项处理。