DeepSeek DeepInfer 完整生产数据公开:96% 缓存命中撑起 155 万亿 token/日,vLLM 复现 decode 差距 6%
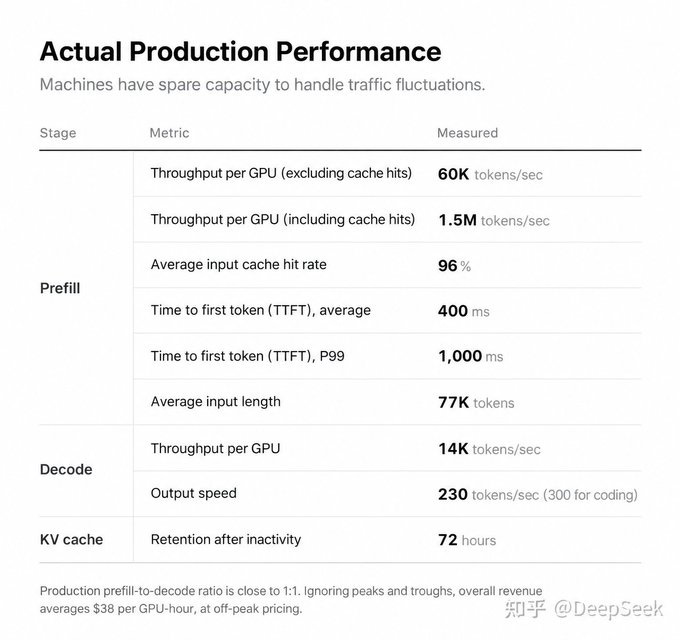
- 前情提要:DeepSeek 此前开源内部推理框架 DeepInfer,官方技术报告给出单集群日吞吐 155 万亿 token、每卡每小时收入 38 美元,但开源版仅提供离线推理,完整在线服务所需的 KV 缓存、PD 分离与副本间负载均衡未包含。deepseek-recipe 同步开放,负责请求格式转换与输出解析。
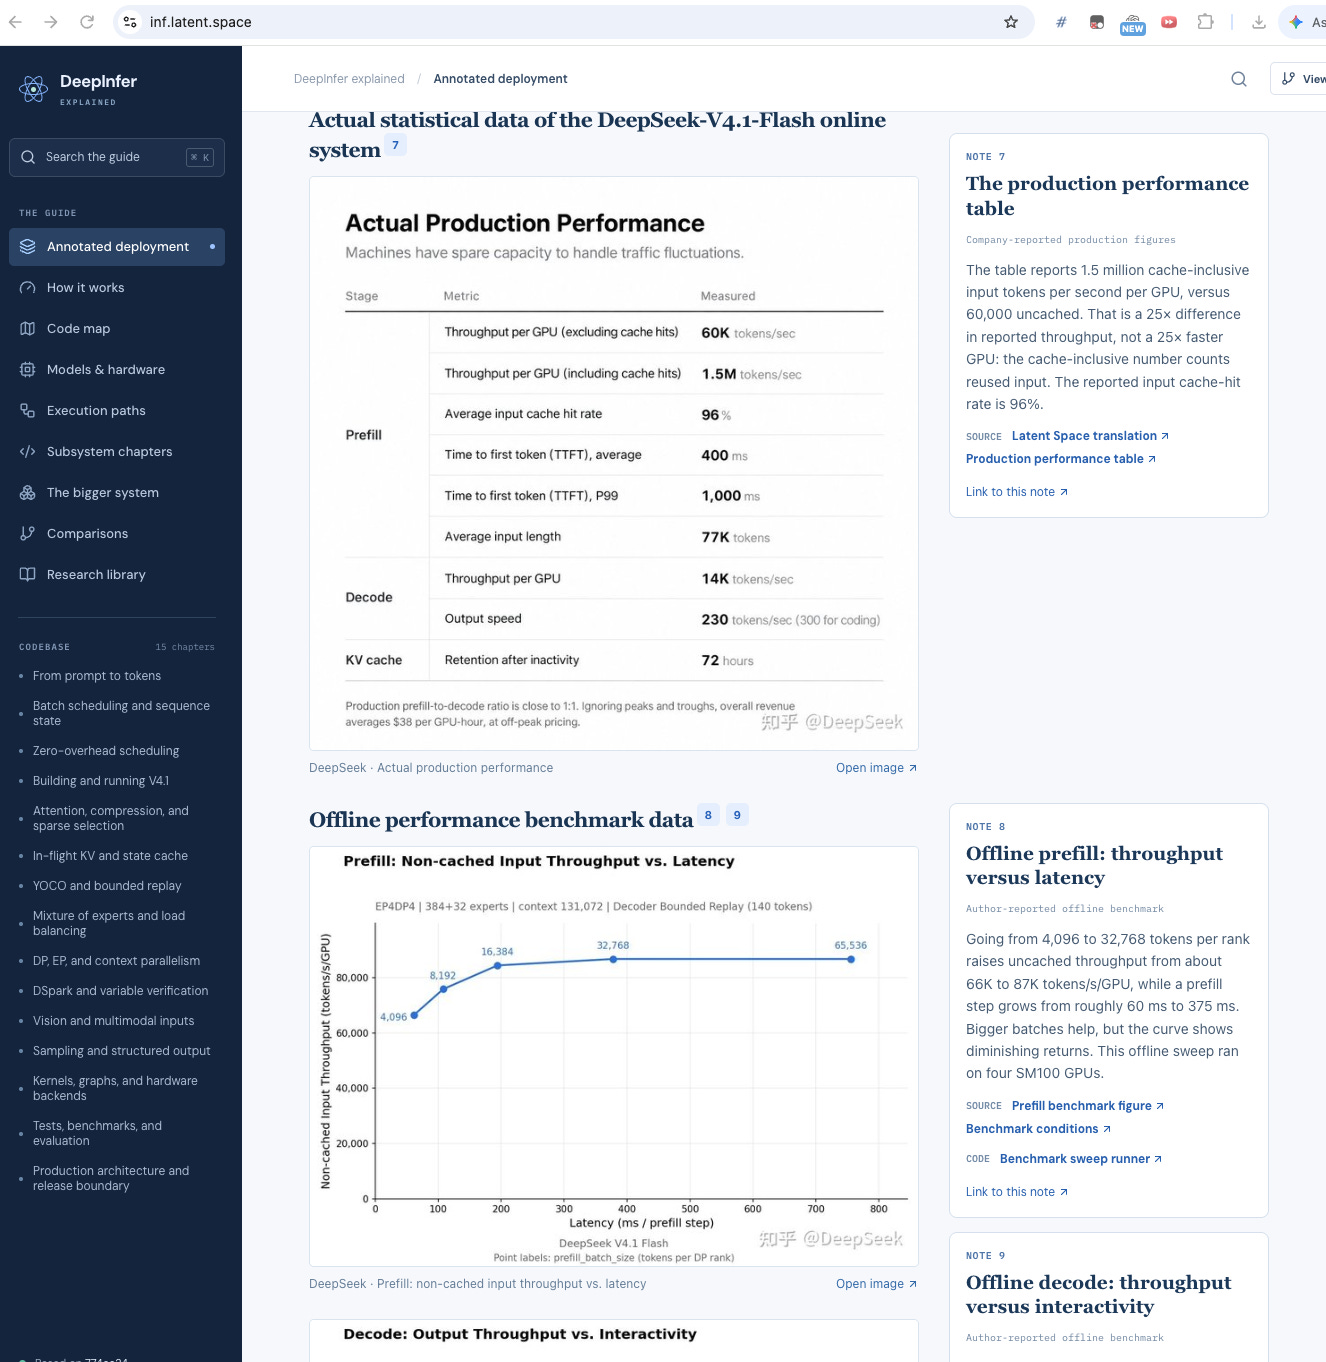
- 最新披露:Latent Space 翻译并公开了完整工程报告与经济学计算。DeepInfer 将 vision encoding、prefill、decode 三阶段拆开部署——prefill 用普通 8 卡机、decode 用 64–128 卡超节点,采用宽专家并行;prefill 调度按估算的 attention compute 分配 chunk,不要求 cache affinity;decode 路由同时按运行请求数与 KV cache 长度均衡,并周期性重分配热门专家副本。
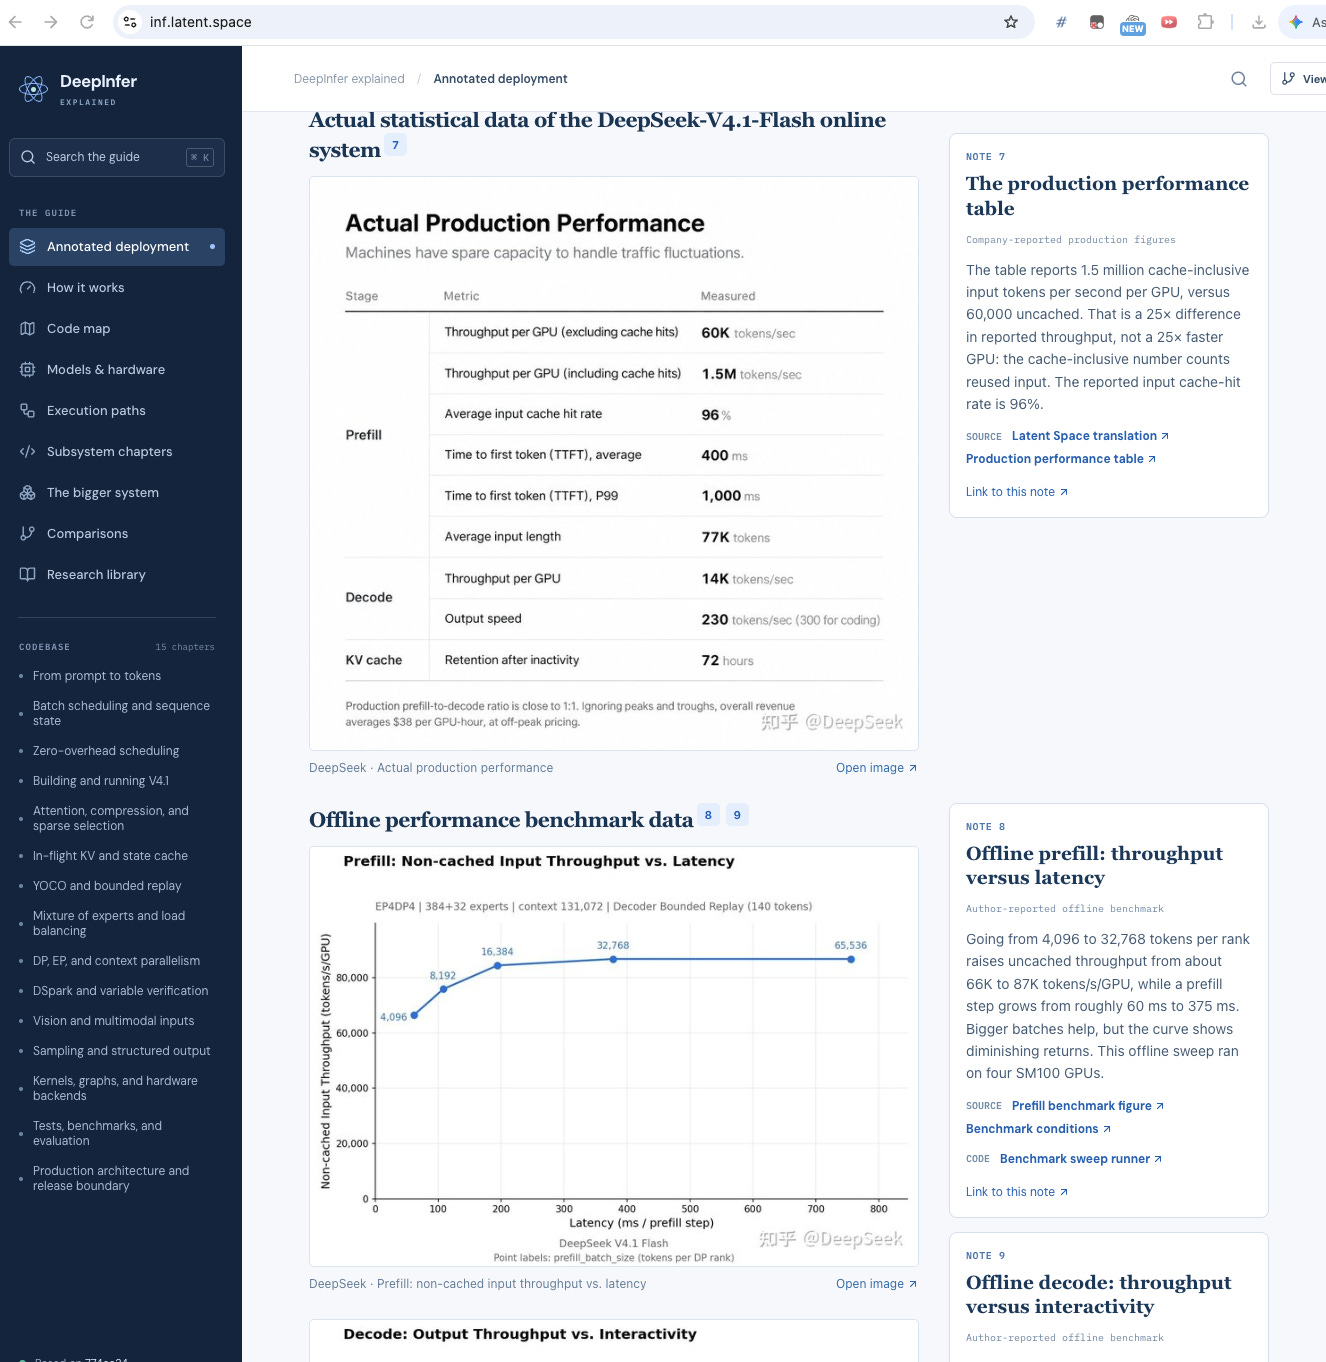
- 缓存与重放机制:持久 KV 缓存在独立 3FS 集群上,约 100 PiB SSD,agent 流量保留 3 天、chatbot 保留 7 天;96% 输入缓存命中率是 155 万亿 token 这一数字的关键前提。SWA Bounded Replay 只从最近 128 个 token 重建滑动窗口状态,官方称接近减半总 prefill 计算;而缓存保留时长的长尾仅带来约 0.5–1 个百分点的额外命中。
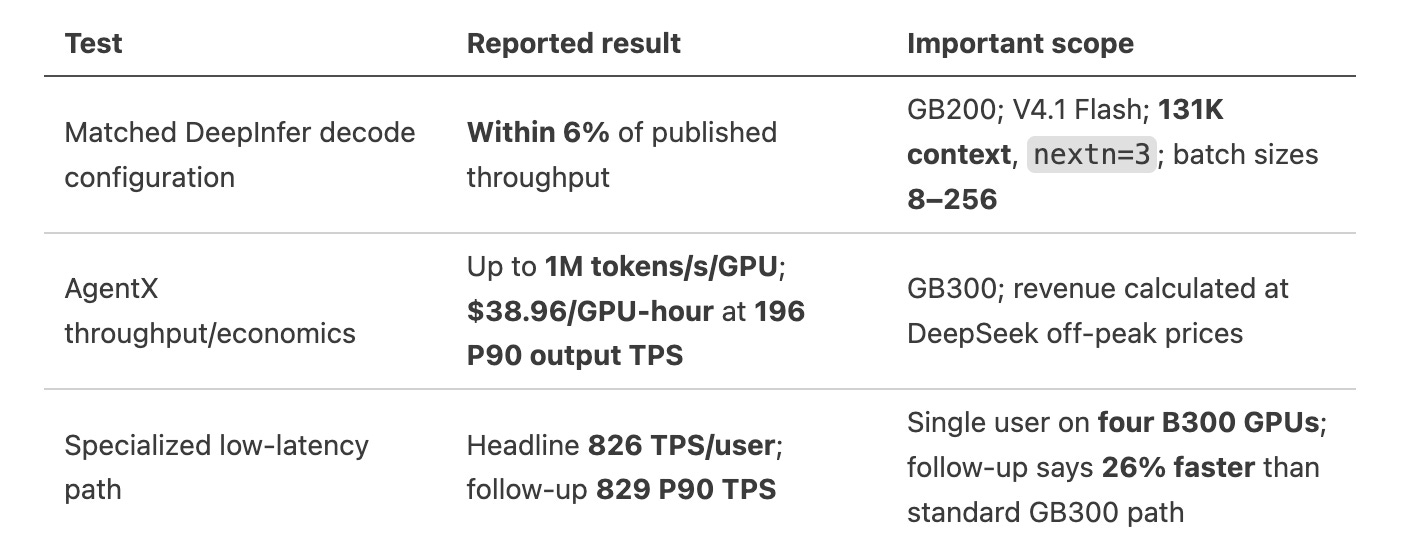
- vLLM 独立对比:DeepInfer 本身是对 vLLM 的定制(Apache 2.0,致谢 vLLM、SGLang、TRT-LLM)。vLLM 团队在 GB200 匹配配置下复现,报告 decode 吞吐与 DeepInfer 公布结果差距在 6% 以内,但明确这不等于复现完整服务——100 PiB 缓存、保留策略、路由与端到端延迟仍属 DeepSeek 内部实现;1M-token/s/GPU 的吞吐数字也需结合输入/缓存/输出配比解读,不能当作单用户生成速度。
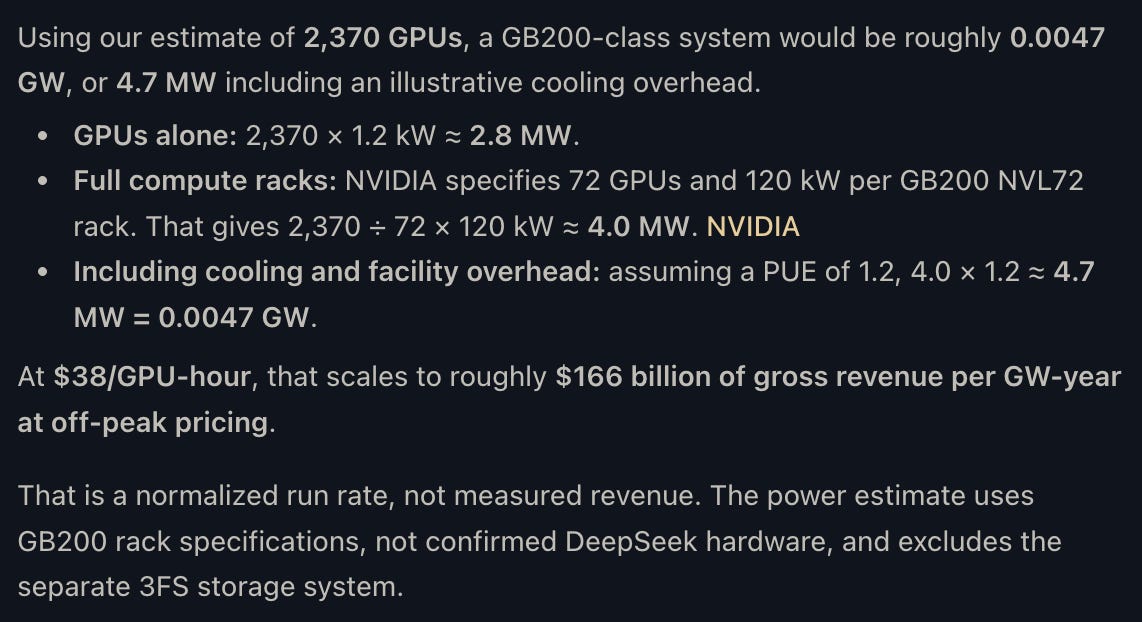
- 经济学边界:$38/加速器小时是收入而非利润。第三方估算以 $5–8/卡·小时全包成本计算,得到 80%+ 的推理毛利与约 81 天回本;若按 $7/小时计算则约 81.6%,但该模型不含 SSD 缓存集群、CPU、网络、闲置容量、故障与工程成本,且高度依赖 96% 缓存命中这一有利负载结构。Teortaxes 等人进一步外推的「$1B ARR 约需 33–42 个 GB200 NVL72 机架」「$100B 年收入约需 4167 机架」均为情景推演,不是审计数据。
- 与 OpenAI 缓存策略对照:OpenAI 同日宣布 API 可选 12 小时提示缓存(默认 30 分钟,可在同一请求内混用不同保留时长),显式瞄准跨小时复用上下文的持久 Agent。两者并非同一产品:DeepSeek 把 retention 做进自有存储层并服务自家模型,OpenAI 把更长保留时间作为 API 选项计费。共同方向是长间隔 Agent 工作流的缓存窗口从分钟级向半天级延伸。
- 服务模型与争议:DeepInfer 支撑的 V4.1 Flash 20261017 在 Agent Arena 位列开放模型第一(总榜第 11),Code Arena: WebDev 开放模型第一,单任务中位成本 $0.20;但在 Vals 的模拟企业网络攻击测试中,第三方指出其 token 消耗约 4.3 倍、耗时约 2.4 倍,效率层面的领先并不与绝对能力挂钩。 🔗 Latent Space 原文 | DeepInfer 技术报告翻译 | DeepInfer GitHub | vLLM 对比说明 | OpenAI 12 小时缓存