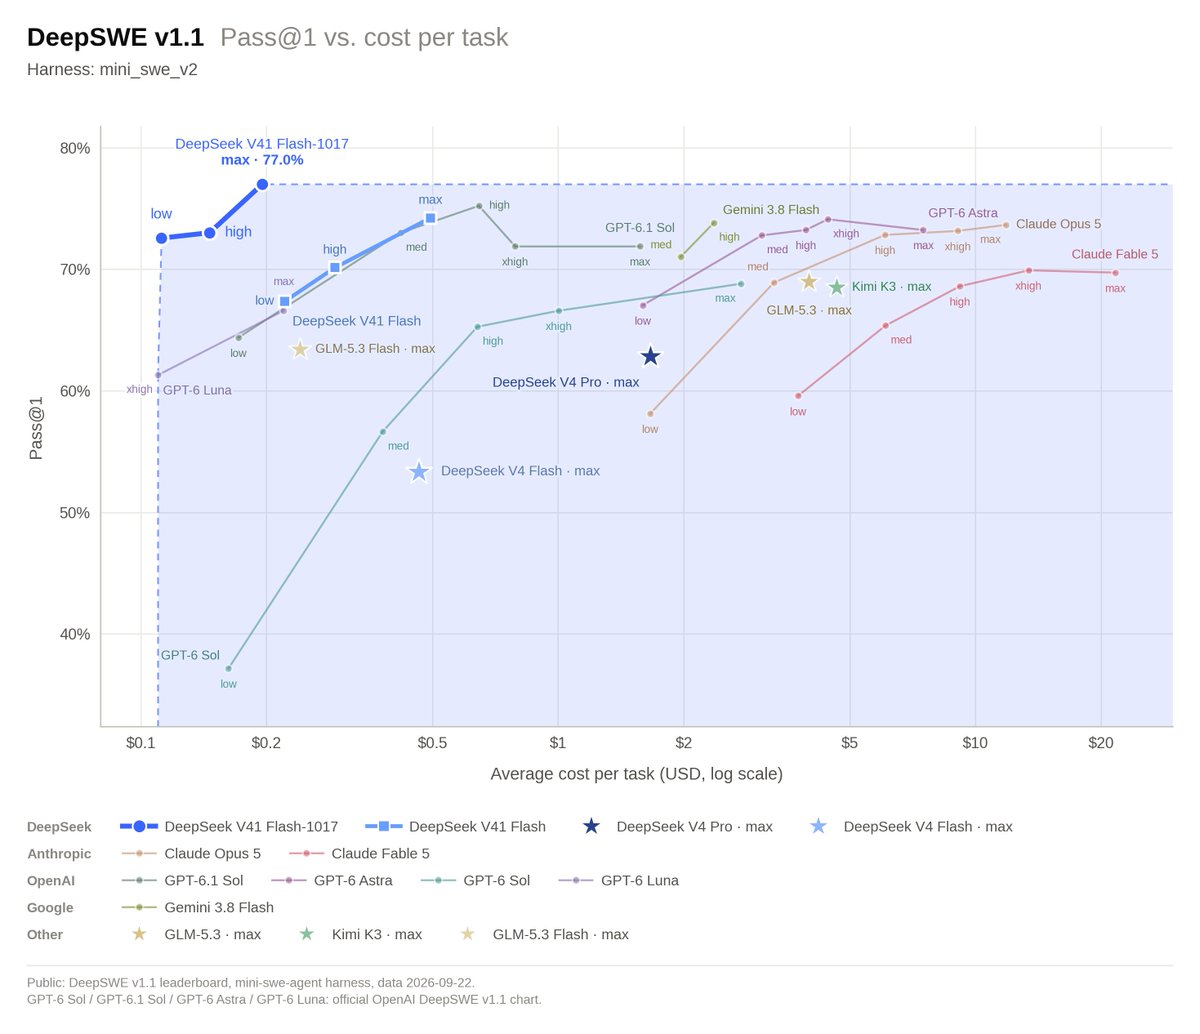
DeepSeek V4.1-Flash-1017 基准细节:Terminal-Bench 4.0 升至 42.3
- 前情提要:DeepSeek 此前发布 V4.1-Flash-1017,官方称其在基准表现、任务完成速度与输出长度上实现帕累托改进,并上线官网、App 与 API;模型延续 MIT 许可开放权重。
- 最新数据:Thomas Wolf 转述称,Terminal-Bench 4.0 从上一版的 31.2 提升至 42.3;DeepSWE 得分为 77.0,对比 Opus 5 的 74.0 与 GPT-5.6 Sol 的 73.0。
- 成本指向:官方与转述均强调更短输出和更快任务完成;在固定任务下减少 token 消耗,会直接影响 Agent 工作流的单位调用成本。
- 信息边界:上述分数来自 DeepSeek 自有评测口径与 Thomas Wolf 的转述,素材未给出完整评测集、运行配置与第三方复现结果。
- 行业观察:终端操作与软件工程类基准正在成为编码 Agent 选型的直接参照;但单点基准领先能否转化为端到端工作流优势,仍取决于任务拆解、错误恢复与外部评测。
🔗 Thomas Wolf 推文 | DeepSeek 官方发布