AWS 发布 Agent Registry 运行时发现:工具不再编译进编排器,改由每次请求现查
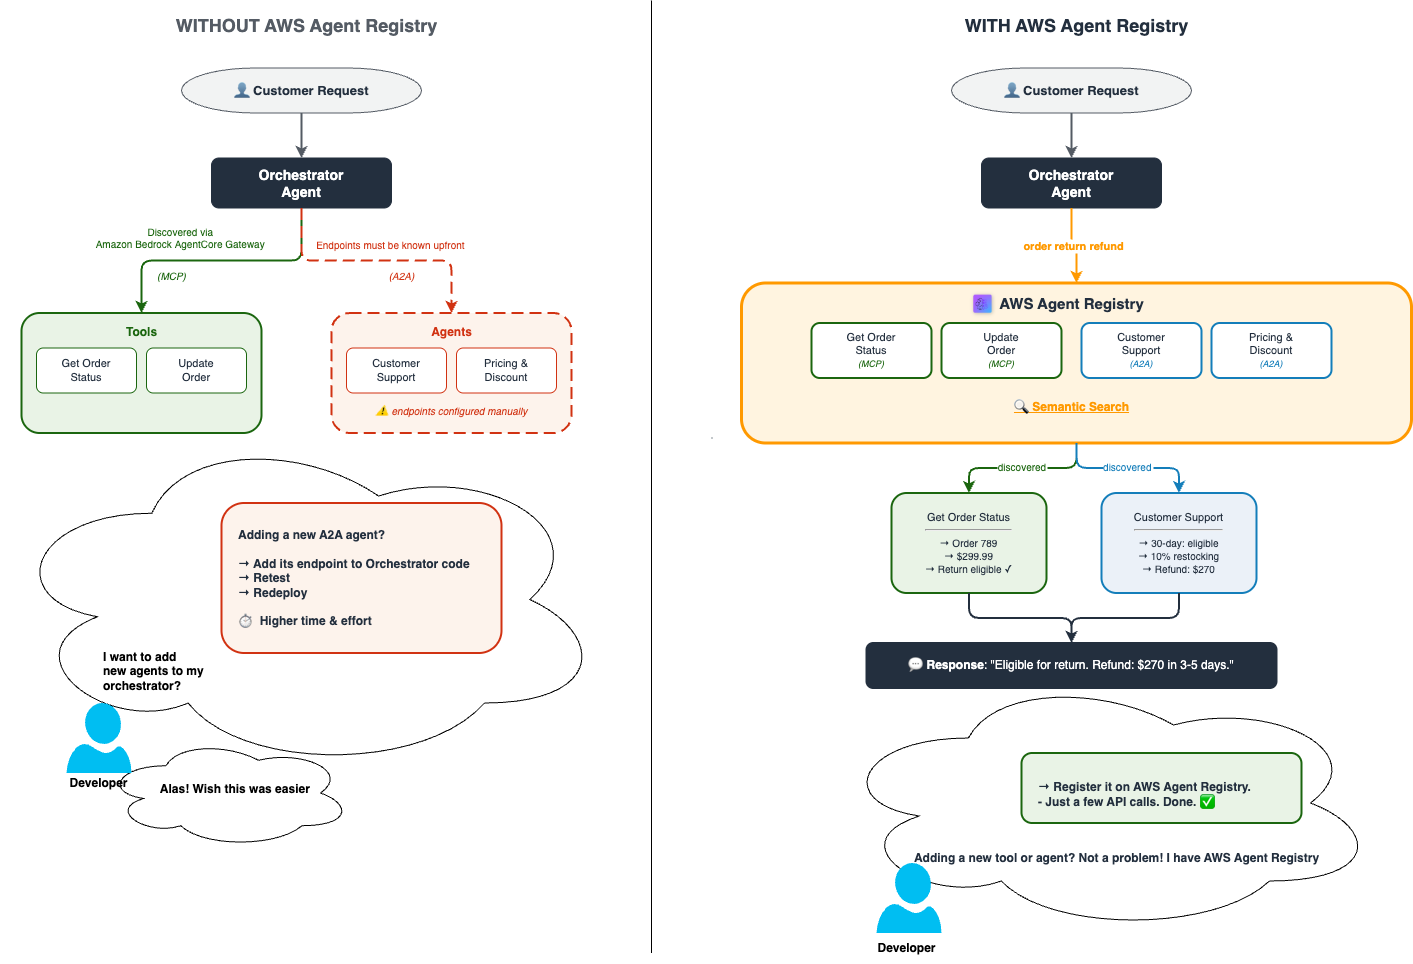
- 问题定义:AWS 在博客中把硬编码工具描述为一条随规模失效的曲线——少量工具可用,几十个开始退化,上百个内部 API(定价、支持、订单、库存、客户数据)时不可管理。模型花在消歧工具名上的 token 可能超过推理用户请求本身,每新增一项能力都要改编排器代码、重新部署并跨团队协调发布。
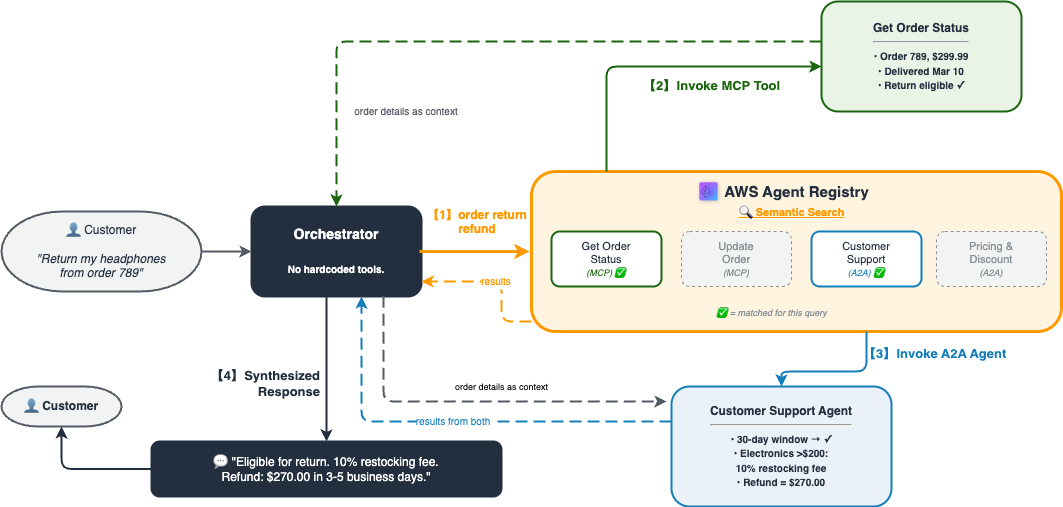
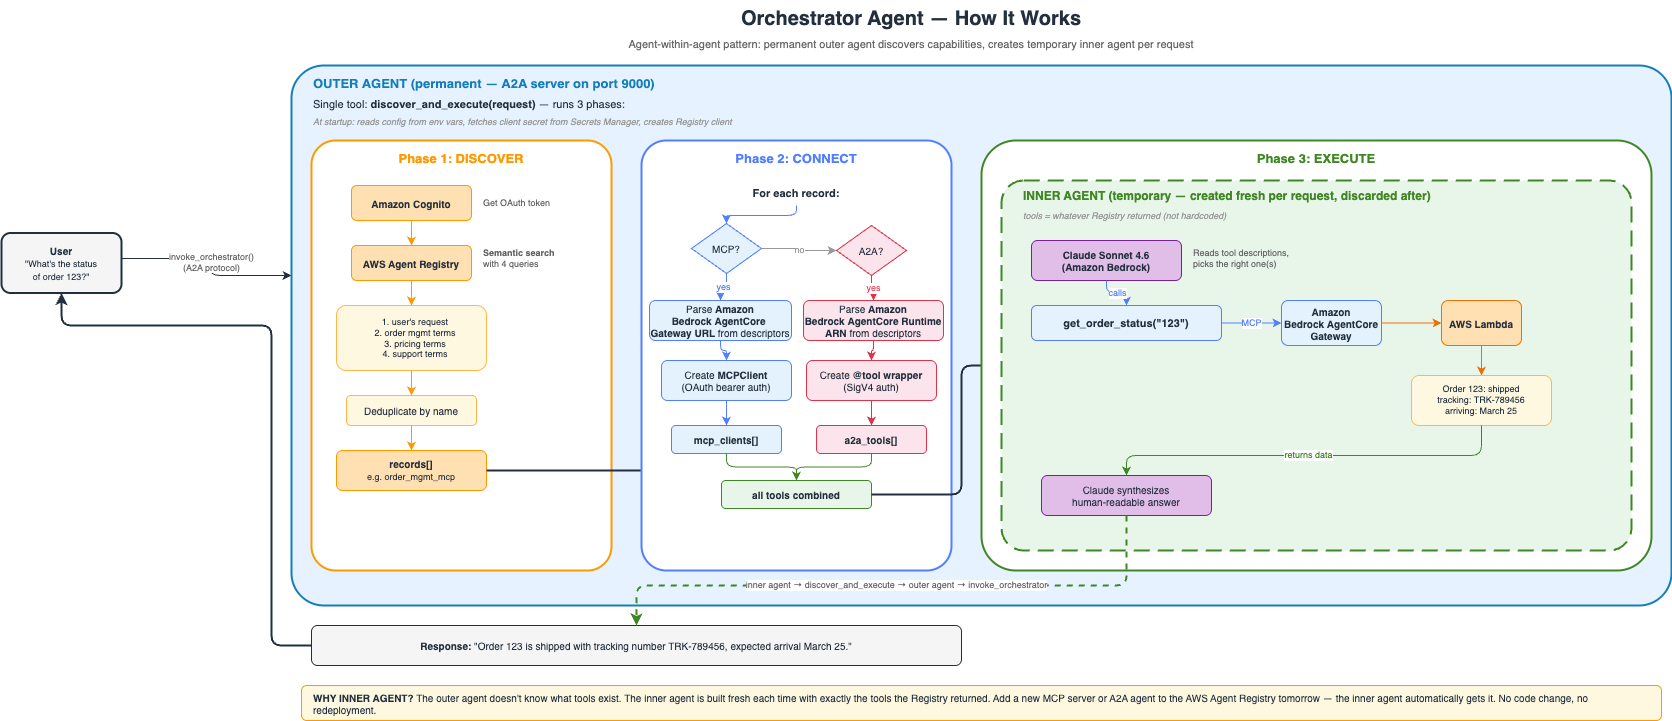
- 机制拆解:AWS Agent Registry 是一个托管目录服务,发布者注册 MCP 服务器、Agent 与技能的协议描述符与可搜索描述;编排器在运行时用混合关键词与语义搜索检索已批准的记录,拿到端点与描述符后现场构建客户端。示例中的编排器没有任何内置工具知识,每个请求构建一个只含动态发现工具的临时内层 agent,回合结束即拆毁,下个请求重新搜索。
- 安全边界:搜索结果包含记录身份、名称、描述、记录类型、状态、版本与协议描述符,不包含调用凭证或鉴权方案。示例中 Gateway 的 OAuth token 单独从 Cognito 与 Secrets Manager 获取,A2A 运行时调用由 boto3 以调用方 AWS 凭证签名——注册中心供给连接元数据,鉴权是另一条独立路径。
- 治理与权限:关闭自动审批后,记录须经
DRAFT → PENDING_APPROVAL → APPROVED两段流转,提交与状态更新均为 IAM 授权操作,发布者与审批者权限可分离;只有通过审批工作流的记录才会出现在可发现数据面。GA 版本另提供组织级发现、跨账户共享、从 URL 自动同步描述符以及 CloudFormation 支持。 - 官方自设的边界:AWS 明确指出这一模式不适用于所有负载——目录小而稳定、或能力始终以固定顺序执行的流水线,显式构建期接线更简单,也省去一次发现请求。博客还专门声明「不假设目录增长会自动改善排序」,搜索质量须用代表性查询评估,描述需以用户语言区分相邻能力。
- 行业意义:Agent 工具接入的分工正在被切开:哪些能力可被发现成为治理问题(审批流、IAM、跨账户共享),如何被调用留在发现路径之外,把多少 schema 塞进上下文则由检索替代全量注入。当企业内部的 MCP 服务器与 A2A agent 从个位数涨到三位数,这套拆分比模型能力更直接地决定单个请求的 token 成本与失败模式;代价是召回质量与排序不再由代码保证,而取决于描述文本与查询设计的持续评估。
🔗 AWS Machine Learning Blog | Agent Registry 文档 | GA 公告 | 示例代码