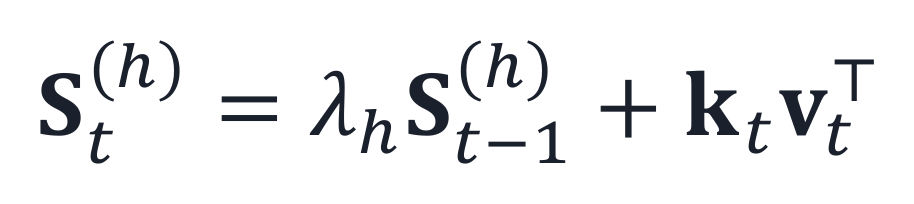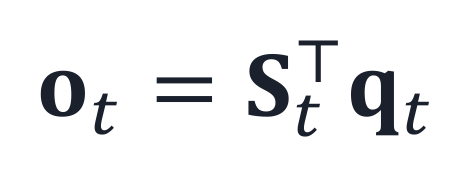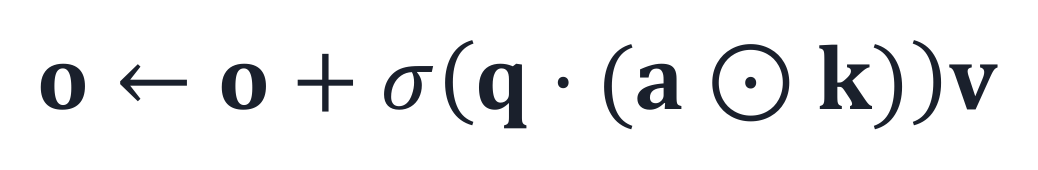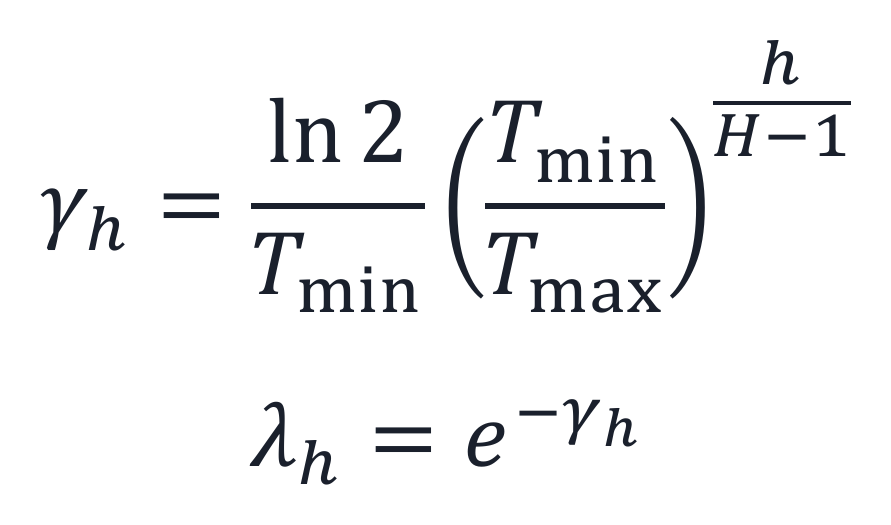i14 在 Trainium2 上用原生 PyTorch 训练并服务 Laplace 3B 线性注意力模型
核心发布:i14 的 Laplace 3B 用 Gated Linear Attention(GLA)替代 softmax 注意力,把历史上下文压缩进固定大小的循环矩阵状态,使每序列推理状态恒为 29.5 MB、不随上下文长度增长;AWS GenAIIC 团队通过 TorchNeuron Native 将该架构带到 Trainium2,保留了 GLA 设计与 Muon 优化器。
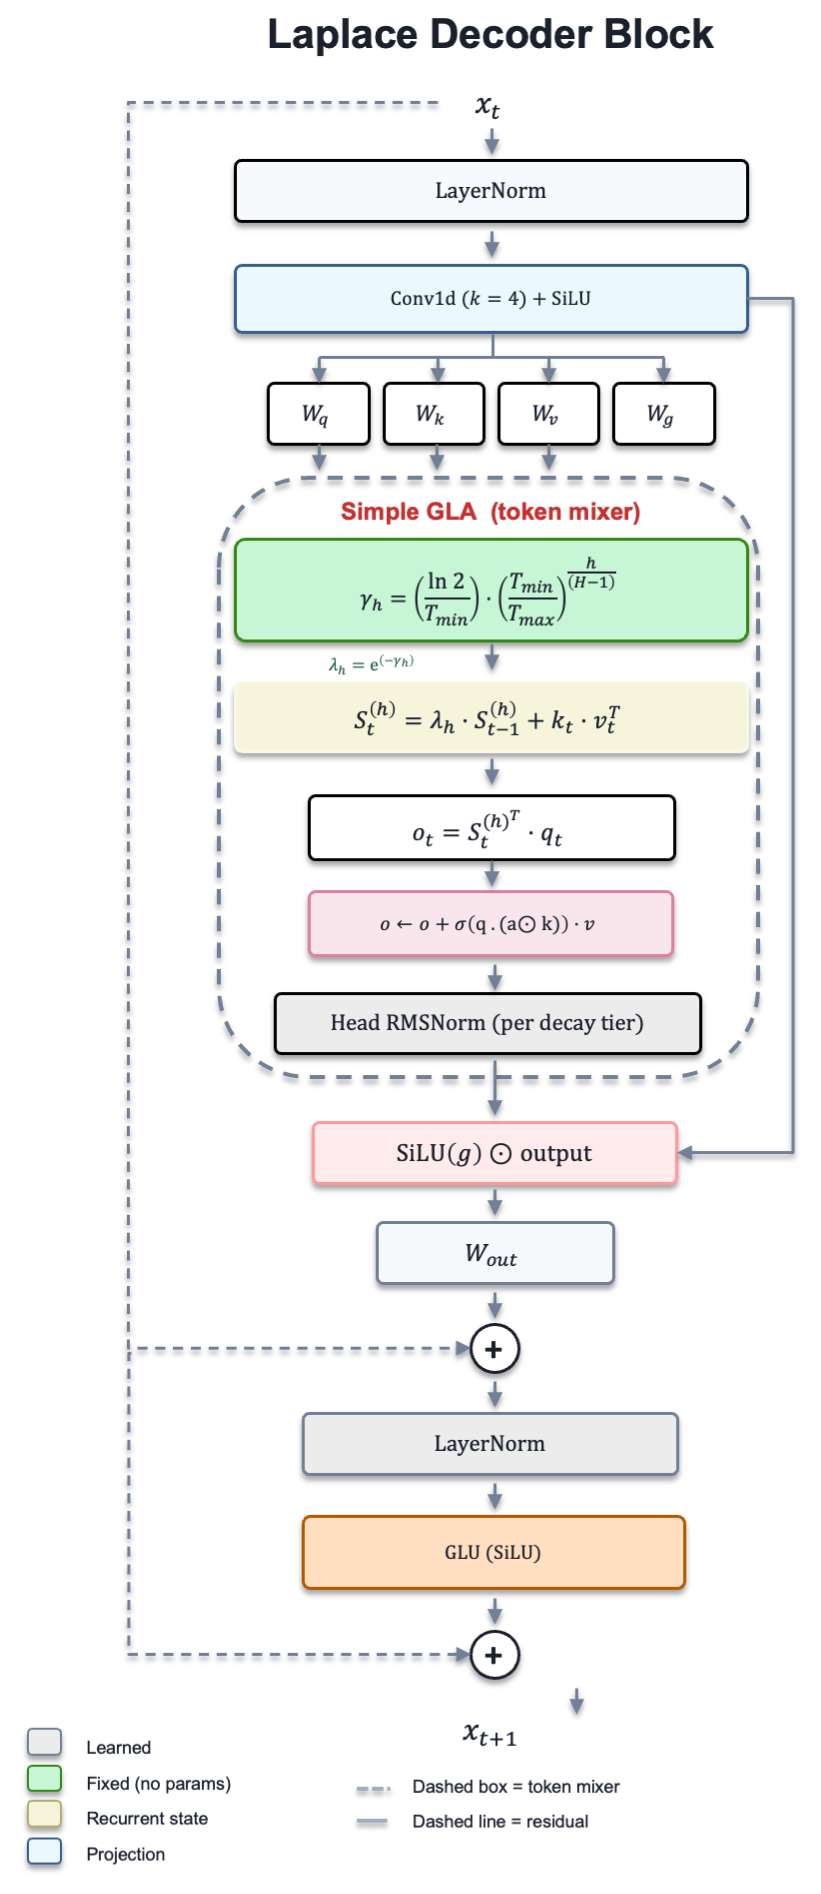
- 模型规格:24 层 decoder,隐藏维度 3,072,16 个注意力头(Q/K 半宽 96、V 全宽 192),每头固定几何衰减(半衰期从 1 token 到 2,048 token 分档),深度可分离 causal Conv1d(k=4)+ GLU FFN(inner 8,192);总参数 3.028B,其中 2.718B 由 Muon 优化、309.6M 由 AdamW 优化,训练语料为 100B FineWeb-Edu token,序列长度 2,048。
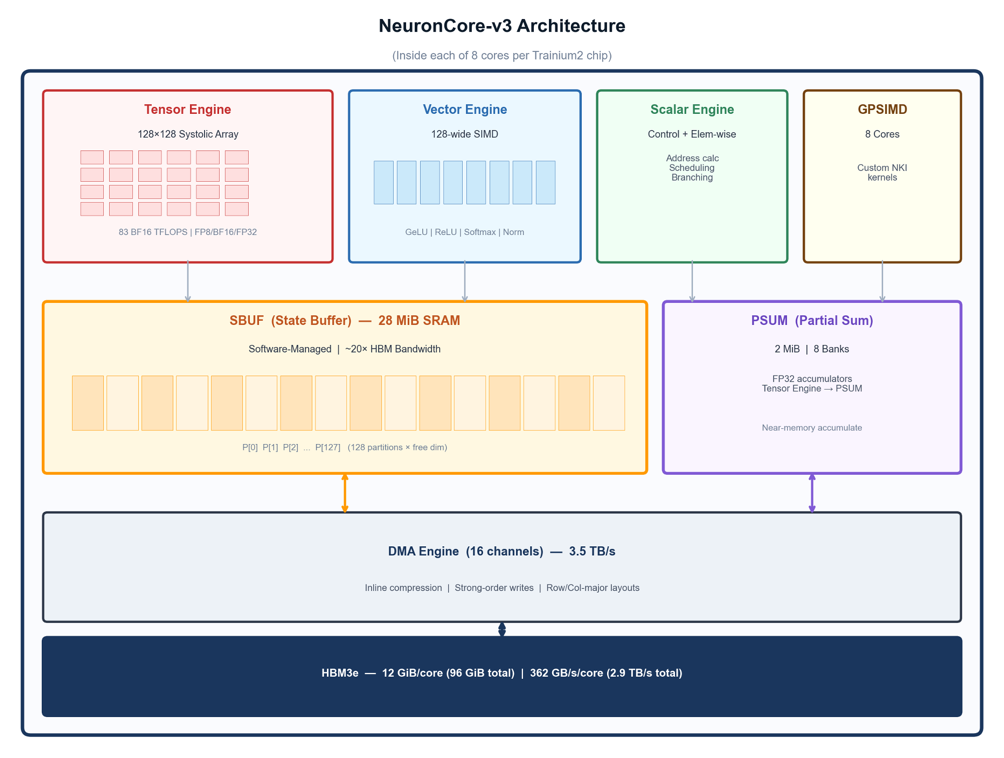
- 训练侧三处改造:其一,把 GPU 上的 Triton fused kernel 重写为标准 PyTorch 算子,以 16 个 128-token chunk 对齐 NeuronCore 的 128 个 SBUF 分区,实测吞吐提升 14%;其二,MuonFSDP2 用两次 all_to_all 转置替代 all_gather,单 rank 每步通信从 10.87 GB 降至 0.45 GB(约 24 倍),吞吐从 73,378 升至 119,934 token/秒(1.63 倍),loss 曲线逐位一致;其三,将 16 步顺序状态更新的反向图静态展开,以同时满足编译器图规模与片上内存约束——32 chunk 会溢出调度器,8 chunk 会让中间量落回 HBM。
- 推理侧实现:使用未经修改的 vLLM 引擎,仅通过 wrapper 替换每个 decoder layer 的 token mixer,读写 vLLM 池中的循环状态;因模型声明为 attention-free,vLLM 每序列只分配一个固定 page。BF16 下输出与 i14 参考实现逐 token 一致(3 个 prompt、48/48 步)。29.5 MB 状态约为 8,192 token 时 KV cache 的 1/82,prompt 从 2,048 增至 8,192 仅使每输出 token 成本增加 0.5%。
- 吞吐数据:eager 模式下单副本 133 输出 token/秒,扩到 64 副本为 6,772(host CPU 使用率达 82%);编译 decode 步骤消除逐算子调度开销后升至 11,544(1.7 倍)。在错峰到达的真实流量下,编译 decode 的每副本吞吐提升 3.52 倍,而固定 batch 基准只显示 1.46 倍——新 batch 宽度的首次编译约需 11 秒,这类步骤仅占 1.1% 却消耗 47.5% 的 decode 时间,padding 到固定宽度后该开销消失。
- 官方自设的边界:线性注意力压缩历史而非保留每个 key/value,检索质量必须按实际工作负载单独评估;BF16 重结合使编译输出与 eager 存在细微差异,需要精确可复现时应使用 eager。AWS 同时说明,这套路径要求架构专用 kernel 与编译器调优,并非把标准 transformer 直接搬过去就能获得同等收益。
- 行业意义:这是 Trainium2 支持非标准 transformer 架构的一份可核对样本——原生 PyTorch 后端在保留自定义注意力与优化器的前提下完成了训练与推理,代价是 chunk 对齐、通信重排与反向图展开三项深度工程改造。对 agentic 系统而言,固定状态改变的是服务约束本身:更长的对话与文档历史不再要求更大的 per-sequence 内存,并发容量与单任务成本可以分开规划,而不必随上下文线性膨胀。 🔗 AWS Machine Learning Blog