GPT-OSS-20B 多语言微调实验:SFT 补能力、GRPO 补余量,给出可先验检查的分工判据
- 问题量化:GPT-OSS-20B 是"用英语思考"的开放权重推理模型——在 50 例多语言测试中,只有 22% 按系统提示指定的语言生成思维链(英语 100%、法语 0%、德语 10%、西班牙语 0%、意大利语 0%),模型收到指令后会口头确认,随后仍切回英语推理。
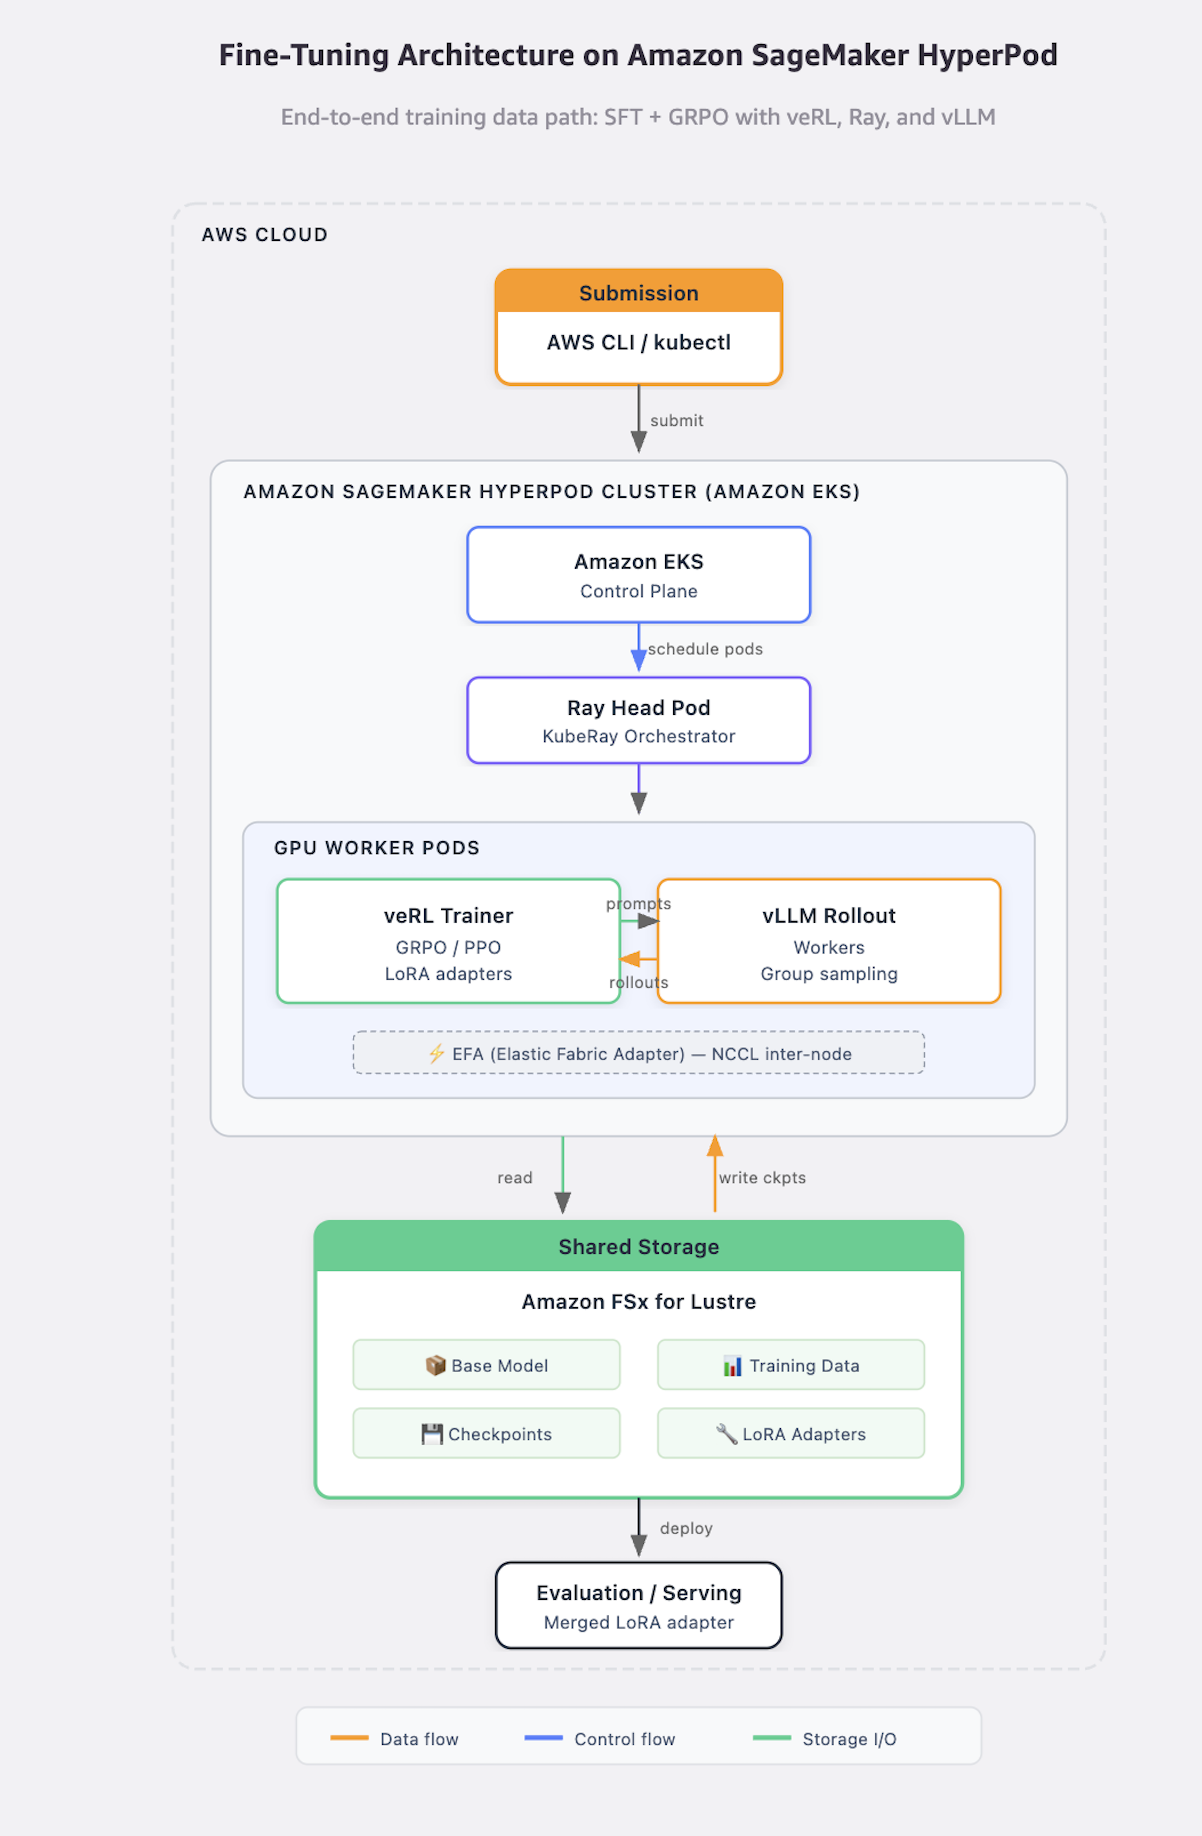
- 训练配置:在 SageMaker HyperPod(EKS 编排)上用 LoRA r=8/α=16 做 SFT,4×ml.g6e.12xlarge(16×L40S 48GB)、FSDP full-shard、bf16 + 梯度检查点,1000 步;GRPO 在 SFT checkpoint 基础上换新 LoRA(约 13.6M 可训练参数),K=8 生成、lr 1e-6、10 epoch,奖励含答案语言 ±5.0、推理语言 ±1.5、简洁性 +0.5/−1.0。Qwen2.5-7B 对照组改用 veRL + vLLM + Ray/KubeRay。
- SFT 结果:思维链语言正确率 22%→100%(50/50),但答案语言只到 62%;分语种为法语 60%、德语 60%、西班牙语 30%、意大利语 60%、英语 100%。作者指出这是两阶段学习——约 200 步学会"用目标语言推理",约 1000 步才学会"用目标语言给答案",后者更难,因为最终答案短、英语先验最强。
- GRPO 增益:在同一 checkpoint 上跑 GRPO,答案语言 62%→70%(+8 点),思维链保持 100%,未破坏 SFT 已学到的行为;分语种法语 70%、德语 80%、西班牙语 60%、意大利语 40%。
- 对照实验推翻"GRPO 万能":Qwen2.5-7B 在多语言任务上有余量,SFT 把答案语言从 0% 提到 38%,GRPO 再加 6 点到 44%;但同一模型在 GSM8K 上基础分已 90.5%,GRPO 跑 30 步仍是 90.5%——组内样本几乎全对时,组相对优势归零,梯度消失。
- 可操作的判据:作者给出的决策框架是——模型完全做不到的行为用 SFT;模型有时能做对、存在余量的行为用 SFT 后再 GRPO 拿几个点;模型已接近峰值或目标行为基础概率为零时,GRPO 不产生收益。落地前应先验证 pass@k 显著高于 pass@1,否则不必消耗 GPU 时长。
- 信息边界:上述分数来自 AWS 官方博客与其自建 50 例评测集,超参、数据与脚本已在 awsome-distributed-ai 仓库公开,但尚未见第三方在更大评测集上复现;GRPO 的 +6~8 点增益属于该方法在此任务上的现实上限区间,不宜外推。 🔗 AWS Machine Learning Blog | 示例代码仓库 | 数据集